第 15 課 - 文字渲染
文字渲染是高度複雜的過程,2024 年文字渲染現況 有非常詳細的介紹,非常推薦閱讀。
在這一課,你會學到下列內容:
- 什麼是 TextMetrics,以及如何在伺服器端與瀏覽器端取得它
- 什麼是 Shaping
- 文字分段與自動換行、BiDi,以及複合字元
- 如何產生 SDF 圖集並用它來繪製
- 如何處理 emoji
對於習慣使用瀏覽器提供的 Canvas 2D 繪製文字 或 SVG 的開發者來說,文字渲染的複雜度可能超出想像。下圖來自 現代 Linux 文字渲染:概覽,展示了文字渲染的資料流:從文字到字形,再到點陣化,最後畫到螢幕上。稍後會簡短介紹 HarfBuzz、FreeType、Bidi,以及目前最流行的字型格式 OpenType。有趣的是,HarfBuzz 是波斯語裡「open type」的說法。

依我過去在網頁視覺化專案中的經驗,mapbox 中的文字渲染 可能更有實務上的啟發,因為我們不會直接接觸上述鏈條中的大多數工具。不過,盡可能理解這個過程,會幫助你掌握文字渲染的本質。
塑形
讓我們從輸入開始。給定一段文字與一個字型,字型以 fontstack 的形式提供,因此是一個陣列:
{
    "text-field": "Hey",
    "text-font": ["Open Sans Semibold", "Arial Unicode MS Bold"]
}
字型堆疊
字型堆疊(fontstack)是一份有序清單,由一個主要字型與可選的後備字型組成。 https://docs.mapbox.com/help/troubleshooting/manage-fontstacks/
什麼是 Shaping?下圖來自 mapbox 中的文字渲染。簡而言之,就是依序放置每個字元的位置,當然還要考慮許多情況,例如遇到換行:

下圖來自 現代 Linux 文字渲染:概覽

要正確放置字元,我們需要取得 TextMetrics。即使是最簡單的並排放置,至少也要知道每個字元的寬度。下面著重說明如何在瀏覽器端取得它。
TextMetrics
HTML 規範提供了 TextMetrics 的定義,分成水平與垂直兩組:
// @see https://html.spec.whatwg.org/multipage/canvas.html#textmetrics
interface TextMetrics {
  // x-direction
  readonly attribute double width; // advance width
  readonly attribute double actualBoundingBoxLeft;
  readonly attribute double actualBoundingBoxRight;

  // y-direction
  readonly attribute double fontBoundingBoxAscent;
  readonly attribute double fontBoundingBoxDescent;
  readonly attribute double actualBoundingBoxAscent;
  readonly attribute double actualBoundingBoxDescent;
  readonly attribute double emHeightAscent;
  readonly attribute double emHeightDescent;
  readonly attribute double hangingBaseline;
  readonly attribute double alphabeticBaseline;
  readonly attribute double ideographicBaseline;
};
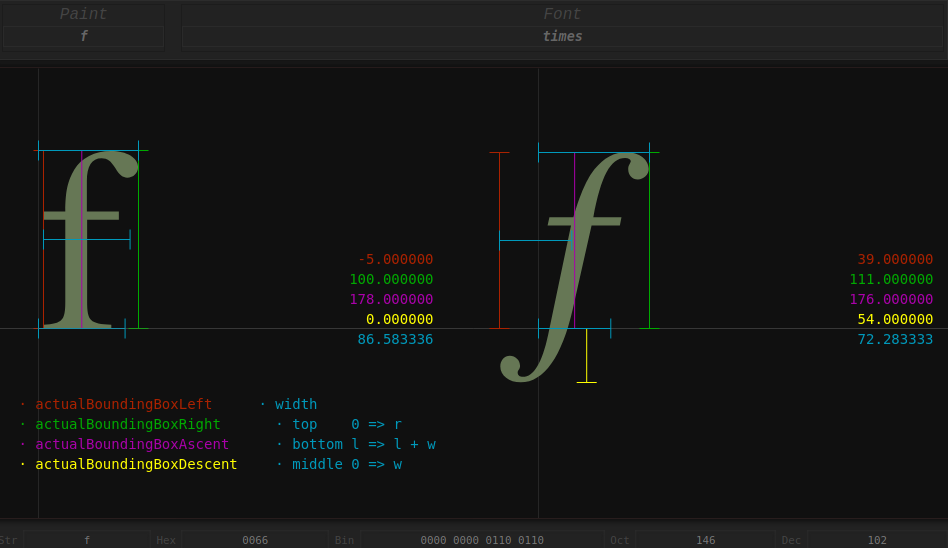
先看三個水平屬性。下圖來自 width 與 actualBoundingBoxLeft(Right) 的差異,可以看出 width 與 actualBoundingBoxLeft/Right 並不相同。簡而言之,後者代表字元的最大邊界(垂直方向的 actualBoundingBoxAscent/Descent 也一樣),而前者(藍色)完全可能小於後者之和(紅色 + 綠色)。例如圖右側的斜體 f,若考慮 font-kerning,下一個字元仍是 f 時,這兩個 f 可以交錯並排。
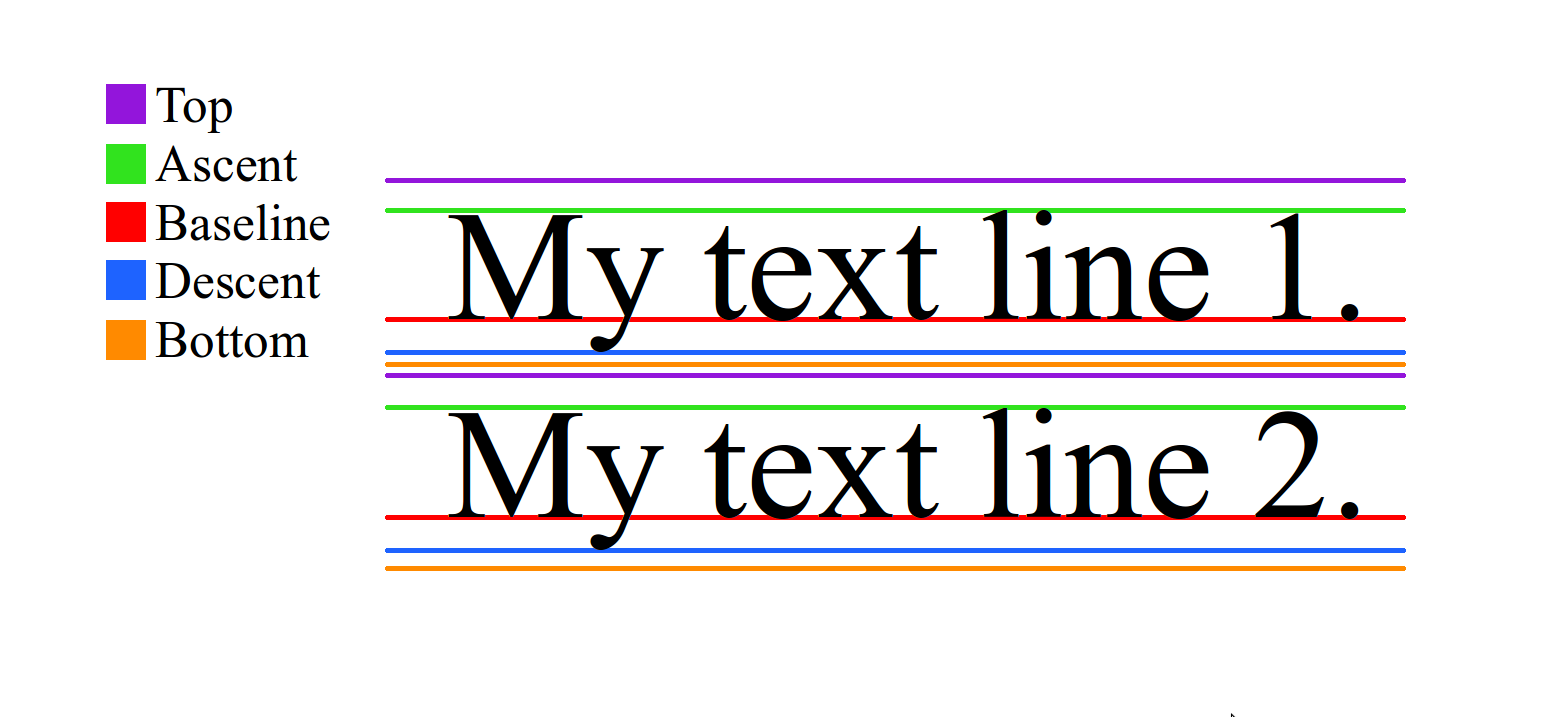
再看垂直屬性。下圖來自 Android FontMetrics 中 top、ascent、baseline、descent、bottom 與 leading 的意義。先找到 text-baseline,以 Ascent/Descent 結尾的屬性都是以它為基準:
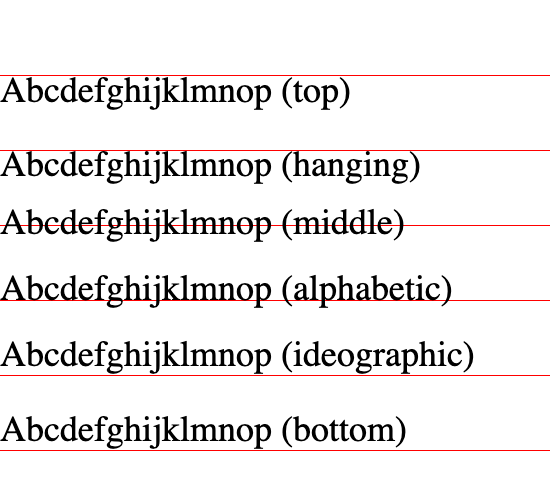
text-baseline 的值可以參考 text-baseline,如下圖。例如取 hanging 時,hangingBaseline 的值是 0,alphabeticBaseline 的值則是從 alphabetic 到 hanging 的距離。
最後,fontBoundingBoxAscent/Descent 是字型本身的最大邊界,actualBoundingBoxAscent/Descent 是實際繪製時字型的最大邊界,因此前者適合用來畫一致的文字背景,不會隨著內容變化而高低不齊。
measureText
如何取得 TextMetrics?Canvas 2D API 提供 measureText,但實際使用時必須考慮只有 width 可用的情況。以 PIXI.TextMetrics 為例,實作中就考慮了這一點:若 actualBoundingBoxLeft/Right 都是 0,就使用 width:
let textMetrics = PIXI.TextMetrics.measureText('Your text', style);

// @see https://github.com/pixijs/pixijs/blob/dev/src/scene/text/canvas/CanvasTextMetrics.ts#L334
const metrics = context.measureText(text);
let metricWidth = metrics.width;
const actualBoundingBoxLeft = -metrics.actualBoundingBoxLeft;
const actualBoundingBoxRight = metrics.actualBoundingBoxRight;
let boundsWidth = actualBoundingBoxRight - actualBoundingBoxLeft;
return Math.max(metricWidth, boundsWidth);
對於和字型相關的屬性,會選幾個有代表性的字元,以確保能測到 Ascent/Descent;如果沒取到,就使用使用者手動輸入的 fontSize 值。
// @see https://github.com/pixijs/pixijs/blob/dev/src/scene/text/canvas/CanvasTextMetrics.ts#L779
context.font = font;
const metrics = context.measureText(
    CanvasTextMetrics.METRICS_STRING + // |ÉqÅ
        CanvasTextMetrics.BASELINE_SYMBOL, // M
);

const properties = {
    ascent: metrics.actualBoundingBoxAscent,
    descent: metrics.actualBoundingBoxDescent,
    fontSize:
        metrics.actualBoundingBoxAscent + metrics.actualBoundingBoxDescent,
};

if (fontProperties.fontSize === 0) {
    fontProperties.fontSize = style.fontSize as number;
    fontProperties.ascent = style.fontSize as number;
}
除了使用 Canvas 2D API,瀏覽器端還有下列選擇:
- opentype.js
- use-gpu 使用基於 ab-glyph 的 use-gpu-text
- 越來越多應用程式使用 harfbuzzjs,見:2024 年文字渲染現況
在網頁上使用 HarfBuzz 日益普及,起初是轉譯成 JavaScript,最近則透過 harfbuzzjs 交叉編譯成 WebAssembly。Photopea 這類線上相片編輯器就是這樣用的。Simon Cozens 的 Crowbar 是一個 OpenType 塑形除錯網頁應用程式,使用 HarfBuzz 的 buffer-messaging API 建立。Sploot 是 Simon 的另一個網頁應用程式,用來檢視字型。Prezi 與 Figma 的網頁應用程式也使用 HarfBuzz。
正如 HarfBuzz 不做的事 所說,解決單一字元的測量問題還遠遠不夠,接下來我們考慮 letterSpacing。
HarfBuzz 可以告訴你一段塑形後的文字有多寬,這對齊行演算法是有用的輸入,但它對段落、行或行長一無所知。它也不會調整詞與詞之間的間距,好讓它們按比例排進一行。
letterSpacing
Canvas 2D API 提供 letterSpacing,可以用來調整字元之間的間距。我們在測量文字之前設定它:
measureText(
    text: string,
    letterSpacing: number,
    context: ICanvasRenderingContext2D
) {
    context.letterSpacing = `${letterSpacing}px`;
    // Omitted measurement process
}
隨後排列每個字元的位置時也必須考慮,我們會在 產生四邊形 介紹。
段落版面
單一字元組成句子,句子再組成段落。下圖來自 文字版面是一層鬆散的分段階層,由下而上展示文字版面的階層結構。

Canvas 2D API 在文字繪製上不提供和段落相關的能力,只有最基本的 繪製文字 功能。基於 Skia 的 CanvasKit 擴充了這一點,另外提供 drawParagraph 方法,見:CanvasKit 文字塑形
CanvasKit 相較於 HTML Canvas API 最大的功能之一,就是段落塑形。
const paragraph = builder.build();
paragraph.layout(290); // width in pixels to use when wrapping text
canvas.drawParagraph(paragraph, 10, 10);
讓我們從段落分段開始。
段落分段
最簡單的分段依據是明確的換行。
const newlines: number[] = [
    0x000a, // line feed
    0x000d, // carriage return
];此外也要考慮自動換行。同時讓每一行盡可能接近相同長度,見:用更好的換行美化地圖標籤
const breakingSpaces: number[] = [
    0x0009, // character tabulation
    0x0020, // space
    0x2000, // en quad
    0x2001, // em quad
    0x2002, // en space
    0x2003, // em space
    0x2004, // three-per-em space
    0x2005, // four-per-em space
    0x2006, // six-per-em space
    0x2008, // punctuation space
    0x2009, // thin space
    0x200a, // hair space
    0x205f, // medium mathematical space
    0x3000, // ideographic space
];
在 CJK 中,有些字元不能出現在行首,有些不能出現在行尾。例如中文裡,大多數標點不能出現在行首。具體規則見:東亞語文的換行規則。pixi-cjk 會處理這些情況:

另一個常見的自動換行情境,是指定了最大寬度,文字超過該寬度就換到下一行。此外還可以設定最大行數,超過這個上限時就套用 text-overflow 屬性。
{
    wordWrap: true,
    wordWrapWidth: 100,
    maxLines: 3,
    textOverflow: TextOverflow.ELLIPSIS,
}
我們可以參考 Pixi.js 中的實作:CanvasTextMetrics
for (let i = 0; i < chars.length; i++) {
    const char = chars[i];
    const prevChar = text[i - 1];
    const nextChar = text[i + 1];
    const charWidth = calcWidth(char);

    if (currentWidth > 0 && currentWidth + charWidth > maxWidth) {
        if (currentIndex + 1 >= maxLines) {
            // 超出最大行数,添加省略号
            appendEllipsis(currentIndex);
            break;
        }

        currentIndex++;
        currentWidth = 0;
        lines[currentIndex] = '';

        if (isBreakingSpace(char)) {
            continue;
        }
    }
}
BiDi
HarfBuzz 不會處理 BiDi,見 HarfBuzz 不做的事:
HarfBuzz 不會幫你處理雙向性。
雙向文字
支援處理混有由左至右(英文)與由右至左(阿拉伯文或希伯來文)資料的文字。
例如,對於這段混有 LTR 與 RTL 的內容 ABCאבגDEF,我們需要手動改變 RTL 文字的順序,才能顯示正確的效果:
'ABCאבגDEF'.split(''); // ['A', 'B', 'C', 'ג' ,'ב' ,'א', 'D', 'E', 'F']這個問題在瀏覽器中並不好解決,見:Pixi.js 中的 BiDi。mapbox-gl-rtl-text 與 rtl-text 把 International Components for Unicode (ICU) 移植到 WASM,這會增加 JS 套件的體積。不過目前我們可以使用 bidi-js 來處理,遇到 RTL 字元時需要手動反轉:
import bidiFactory from 'bidi-js';

this.#bidi = bidiFactory();
const embeddingLevels = this.#bidi.getEmbeddingLevels(text);
let bidiChars = '';
for (const segment of segmentStack[0]!) {
    const { text, direction } = segment;
    bidiChars += direction === 'ltr' ? text : text.split('').reverse().join('');
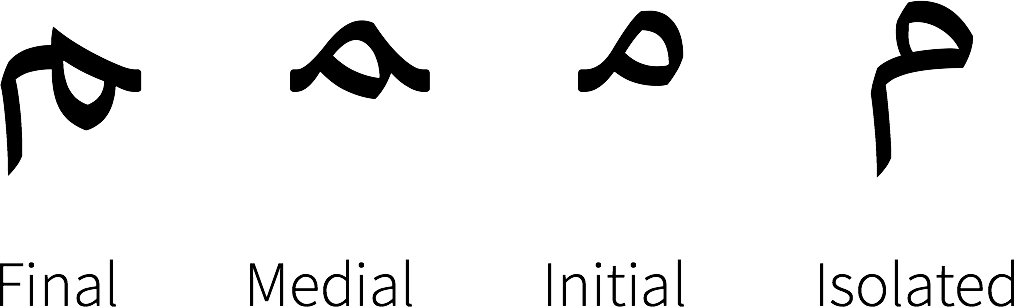
}在印刷體阿拉伯文中,每個字元都可以有「孤立」、「詞首」、「詞中」與「詞尾」四種形式。舉例來說,下面是阿拉伯字母「meem」(U+0645)的四種形式,見:改善地圖標籤中的阿拉伯文與希伯來文。
我們選擇 JavaScript-Arabic-Reshaper,它比 ICU 輕量得多。
import ArabicReshaper from 'arabic-reshaper';

if (direction === 'ltr') {
    bidiChars += text;
} else {
    bidiChars += ArabicReshaper.convertArabic(text)
        .split('')
        .reverse()
        .join('');
}
解決 BiDi 之後,現在要處理複合字元的問題。下面的範例來自 cosmic-text,一個用 Rust 實作的多行文字處理函式庫。
for line in BidiParagraphs::new(&text) {
    for grapheme in line.graphemes(true) {
        for c in grapheme.chars() {}
    }
}
複合字元
並非所有字元都由單一字元組成,clusters 是 HarfBuzz 用來處理複合字元的術語
在文字塑形中,cluster 是一段必須當成單一、不可分割單位來處理的字元序列。
例如 emoji 就是如此。如果把它們當成單一字元處理(例如使用 split('')),無論是測量還是後續繪製,都會被錯誤截斷:
'🌹'.length; // 2
'🌹'[0]; // '\uD83C'
'🌹'[1]; //'\uDF39'
在瀏覽器端,可以使用 grapheme-splitter 這類函式庫,用法如下:
var splitter = new GraphemeSplitter();
// plain latin alphabet - nothing spectacular
splitter.splitGraphemes('abcd'); // returns ["a", "b", "c", "d"]
// two-char emojis and six-char combined emoji
splitter.splitGraphemes('🌷🎁💩😜👍🏳️🌈'); // returns ["🌷","🎁","💩","😜","👍","🏳️🌈"]但它的體積(壓縮後仍有 22kB)不能忽略,見 BundlePhobia grapheme-splitter。因此在 Pixi.js 中,預設使用瀏覽器自帶的 Intl.Segmenter 處理複合字元,大多數現代瀏覽器都支援這項功能:
// @see https://github.com/pixijs/pixijs/blob/dev/src/scene/text/canvas/CanvasTextMetrics.ts#L121C19-L131C10
const splitGraphemes: (s: string) => string[] = (() => {
    if (typeof (Intl as IIntl)?.Segmenter === 'function') {
        const segmenter = new (Intl as IIntl).Segmenter();

        return (s: string) => [...segmenter.segment(s)].map((x) => x.segment);
    }

    return (s: string) => [...s];
})();
我們也採用這個方案,稍後為字元產生 SDF 時會用到。
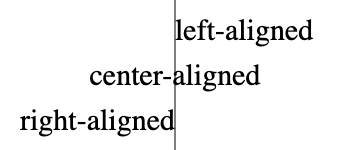
text-align
實作 text-align 很簡單:
let offsetX = 0;
if (textAlign === 'center') {
    offsetX -= width / 2;
} else if (textAlign === 'right' || textAlign === 'end') {
    offsetX -= width;
}但實作垂直對齊就沒那麼簡單。text-baseline 只適用於單行文字,而在許多情境中,我們希望整個段落置中。稍後討論 flex 版面時會介紹。
渲染
下圖展示了 FreeType 字型渲染引擎在流程中的位置:

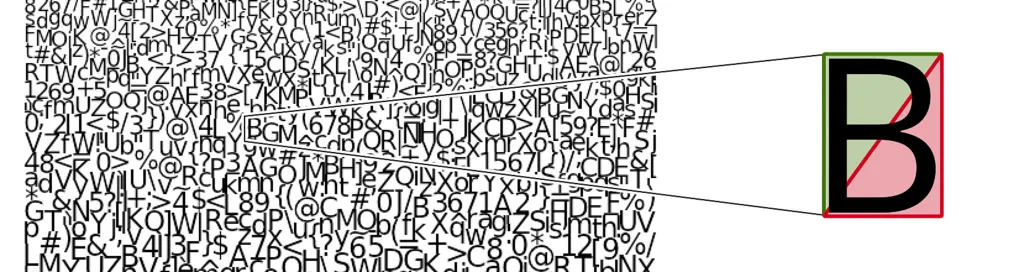
讓我們把焦點放在具體的文字渲染技術。對於字元集有限的拉丁字元,完全可以離線產生字形圖集,並在執行期上傳到 GPU,freetype-gl 就是這樣實作的。
字形圖集是單張影像,會和其他圖塊資料一起作為紋理上傳到 GPU。下面是字形圖集的視覺呈現:
但這種非向量做法的問題是,放大時字元會非常模糊。下圖來自 距離場字型
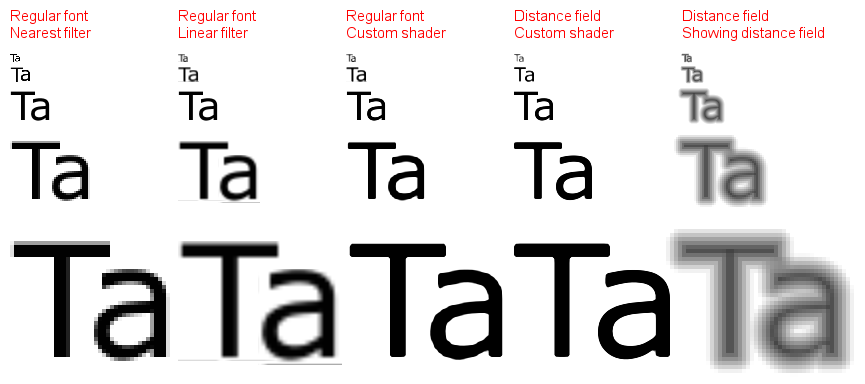
目前主流的 SDF 方案來自 Valve 的論文 向量紋理與特殊效果的改進版 Alpha 測試放大,這個方案的優點包括:
- 縮放之後仍然清晰
- 很容易實作反鋸齒、光暈(Halo)、陰影等效果
但問題是邊緣不夠銳利。雖然在視覺化情境中容忍度較高,也可以透過 msdf 等方法最佳化。此外,SDF 也無法支援 字型微調。
先看單一字元的 SDF 產生情況。
SDF 產生
下圖來自 msdf-atlas-gen,我們關注 SDF 與 MSDF 這兩種圖集:
| 硬遮罩 | 軟遮罩 | SDF | PSDF | MSDF | MTSDF | |
|---|---|---|---|---|---|---|
| 通道: | 1 (1-bit) | 1 | 1 | 1 | 3 | 4 |
| 反鋸齒: | - | 是 | 是 | 是 | 是 | 是 |
| 可縮放性: | - | - | 是 | 是 | 是 | 是 |
| 銳利轉角: | - | - | - | - | 是 | 是 |
| 柔和效果: | - | - | 是 | - | - | 是 |
| 硬邊效果: | - | - | - | 是 | 是 | 是 |
如果允許離線產生,可以使用 msdf-atlas-gen 或 node-fontnik(mapbox 用它在伺服器端產生以 protocol buffer 編碼的 SDF)。但考慮到 CJK 字元,可以在執行期用 tiny-sdf 產生,用法如下。傳入和字型相關的屬性後,就會得到像素資料。
const tinySdf = new TinySDF({
    fontSize: 24,
    fontFamily: 'sans-serif',
});
const glyph = tinySdf.draw('泽'); // Contains pixel data, width and height, character metrics, etc.
讓我們簡短分析它的產生原理。首先,它使用瀏覽器 Canvas2D API getImageData 取得像素資料,但寫入時會留一塊緩衝邊距,這是為了光暈(Halo)的實作。
const size = (this.size = fontSize + buffer * 4);最暴力的遍歷方法
對於二維網格,距離場中的「距離」是歐氏距離,因此 EDT(Euclidean Distance Transform,歐氏距離變換)定義如下。其中
其中第一部分與
因此,我們只需要考慮一維的距離平方:
如果從幾何角度理解上面的一維距離平方場計算公式,它其實是一組拋物線,每條拋物線的最低點在
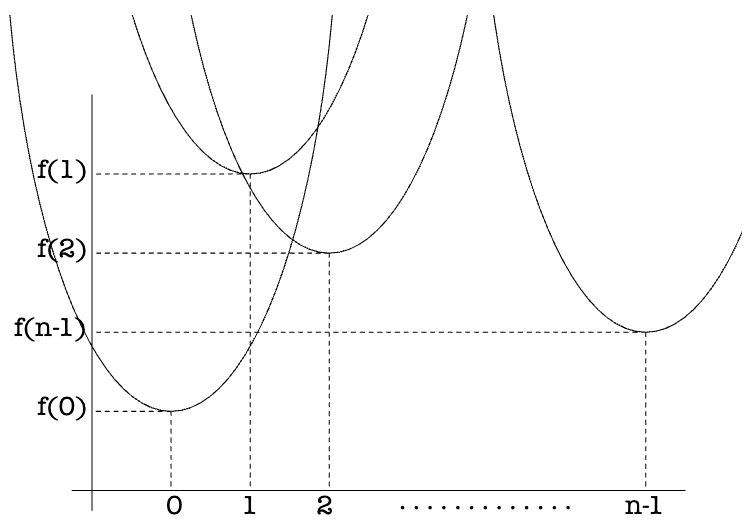
因此,這組拋物線的下界,也就是下圖中的實線部分,代表 EDT 的計算結果:
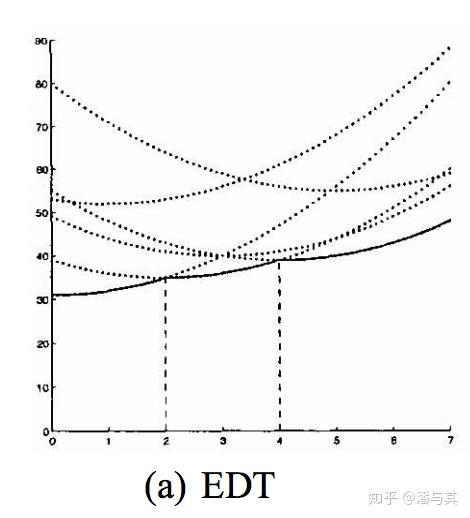
要找出這個下界,需要計算任意兩條拋物線的交點。例如對於兩條拋物線
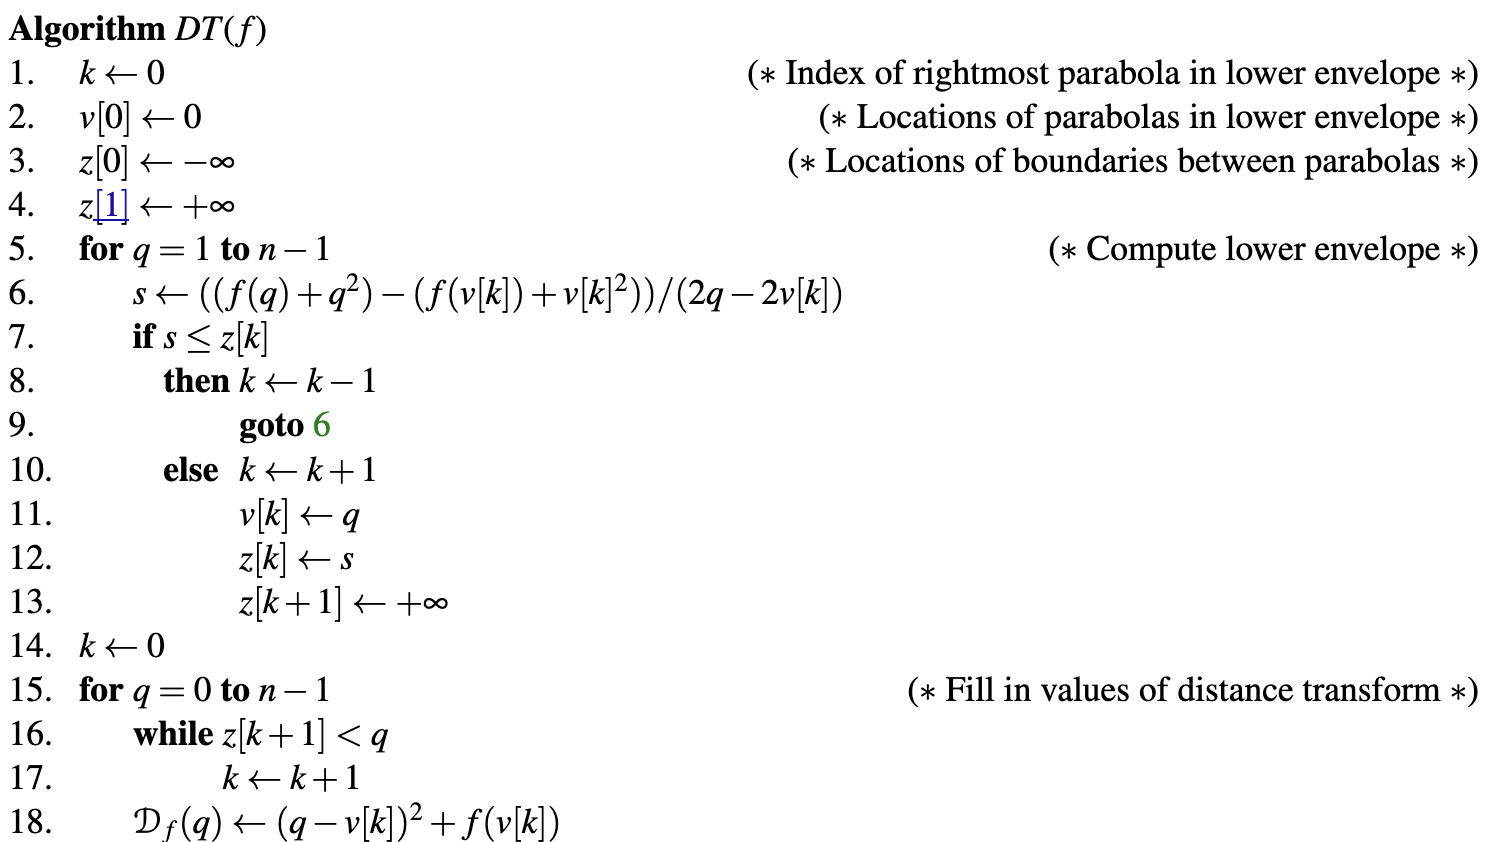
現在我們有了計算 EDT 1D 的知識。把下界中最右側拋物線的序號存在
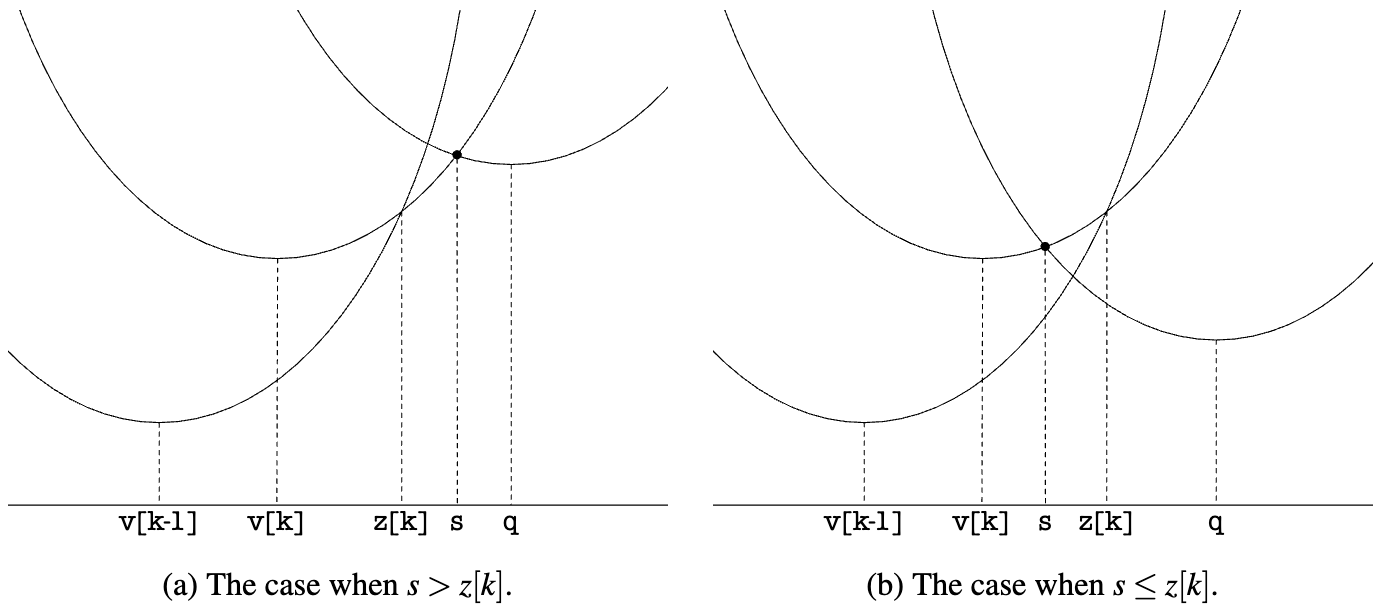
完整演算法如下,tiny-sdf 實作了它(EDT 1D),連變數名稱都一致:
次像素距離變換 詳細介紹了這個演算法的想法:分別計算外部距離場,再把兩者合併:
要做出有號距離場,就對內部與外部各做一次,再把兩者組合成內部減外部,或反過來。
它從最基本的 1D 開始。首先假設輸入只有黑與白,也就是上面提到的 Hard mask,先計算外部距離場:

接著計算內部距離場,I 是把 O 反過來:
最後合併,用外部距離場減去內部距離場:
在 tiny-sdf 的實作中,上面的過程對應 a 為 1 時的處理邏輯:
// @see https://github.com/mapbox/tiny-sdf/blob/main/index.js#L85
gridOuter.fill(INF, 0, len);
gridInner.fill(0, 0, len);

for (let y = 0; y < glyphHeight; y++) {
    for (let x = 0; x < glyphWidth; x++) {
        if (a === 1) {
            // fully drawn pixels
            gridOuter[j] = 0;
            gridInner[j] = INF;
        } else {
        }
    }
}

edt(outer, 0, 0, wp, hp, wp, this.f, this.z, this.v);
edt(inner, pad, pad, w, h, wp, this.f, this.z, this.v);

for (let i = 0; i < np; i++) {
    const d = Math.sqrt(outer[i]) - Math.sqrt(inner[i]);
    out[i] = Math.max(
        0,
        Math.min(255, Math.round(255 - 255 * (d / this.radius + this.cutoff))),
    );
}
2D EDT 的計算,正如本節開頭所介紹的,會拆成兩趟一維距離平方,最後再取平方根。這和後處理中的高斯模糊效果類似:
和傅立葉變換一樣,可以把它套用到 2D 影像:先對每一列 X 做水平方向,再對每一行 Y 做垂直方向(或反過來)。
這裡也可以直接看出,對於大小為 height * width 的網格,複雜度是
// @see https://github.com/mapbox/tiny-sdf/blob/main/index.js#L110
function edt(data, width, height, f, d, v, z) {
    // Pass 1
    for (var x = 0; x < width; x++) {
        for (var y = 0; y < height; y++) {
            f[y] = data[y * width + x];
        }
        // Fix x and calculate 1D distance squared
        edt1d(f, d, v, z, height);
        for (y = 0; y < height; y++) {
            data[y * width + x] = d[y];
        }
    }
    // Pass 2
    for (y = 0; y < height; y++) {
        for (x = 0; x < width; x++) {
            f[x] = data[y * width + x];
        }
        edt1d(f, d, v, z, width);
        for (x = 0; x < width; x++) {
            // Take the square root to get the Euclidean distance
            data[y * width + x] = Math.sqrt(d[x]);
        }
    }
}
解決了單一字元的 SDF 產生問題,下一步是把所有字元的 SDF 合併成一張大圖,稍後當作紋理使用。
字形圖集
單張 SDF 需要合併成一張大圖,才能稍後當作紋理使用,類似 CSS Sprite。這類問題稱為:裝箱問題,把小盒子放進大盒子,合理利用空間以減少空隙。我們選擇 potpack,這個演算法可以盡量得到接近正方形的結果,缺點是產生版面之後不允許修改,只能重新產生。
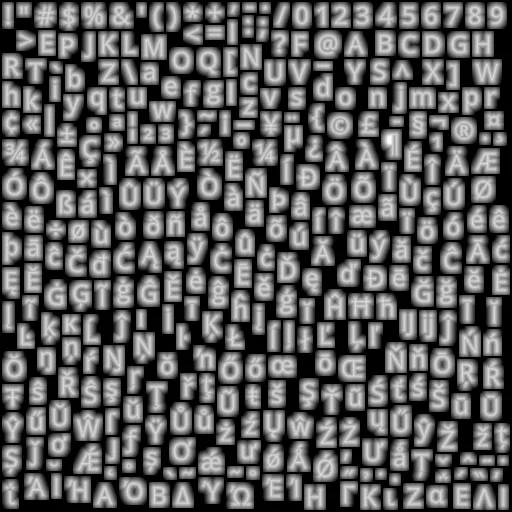
圖集存放一個文字批次目前使用的字形。第一次建立時也會包含一個空白字形,讓空文字有有效的度量。新字元,或字型家族、字重、樣式或填色的變更,都可能重建圖集;只改變字型大小則會重用它。只產生可見字元,可以避免在匯入含有大量標籤的 SVG 時,為每種文字樣式都烘焙 96 個未使用的 ASCII 字形。
這張紋理只需要使用一個通道。如果是 WebGL,可以使用 gl.ALPHA 格式,但 WebGPU 沒有對應格式。因此我們使用 Format.U8_R_NORM 格式,它在 WebGL 中是 gl.LUMINANCE,在 WebGPU 中是 r8unorm。
this.glyphAtlasTexture = device.createTexture({
    ...makeTextureDescriptor2D(Format.U8_R_NORM, atlasWidth, atlasHeight, 1),
    pixelStore: {
        unpackFlipY: false,
        unpackAlignment: 1,
    },
});
然後在著色器中,從 r 通道取得有號距離:
uniform sampler2D u_SDFMap; // glyph atlas
varying vec2 v_UV;

float dist = texture2D(u_SDFMap, v_UV).r;
以上是片段著色器中的繪製邏輯。接下來看看如何計算傳入頂點著色器的每個字元位置。
產生四邊形
首先,需要把每個字形從字形資料轉成兩個三角形(稱為 "quad"),包含四個頂點:
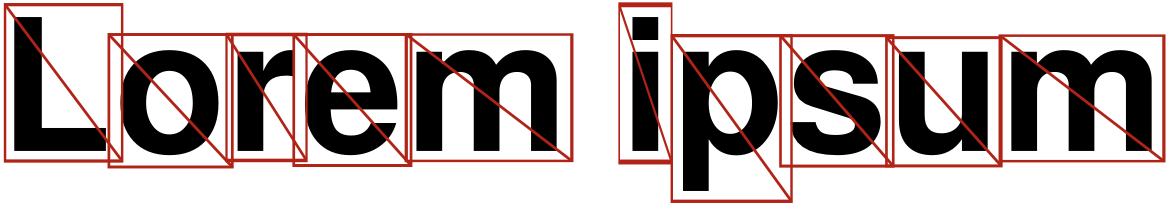
簡化後的字形資料 SymbolQuad 定義如下:
// @see https://github.com/mapbox/mapbox-gl-js/blob/main/src/symbol/quads.ts#L42
export type SymbolQuad = {
    tl: Point; // The coordinates of the four vertices in local coordinates
    tr: Point;
    bl: Point;
    br: Point;
    tex: {
        x: number; // Texture coordinates
        y: number;
        w: number;
        h: number;
    };
};
對於每一筆字形資料,把它拆成四個頂點,其中 uv 與 offset 合成一個 stride,再在頂點著色器中透過 a_UvOffset 存取:
glyphQuads.forEach((quad) => {
    charUVOffsetBuffer.push(quad.tex.x, quad.tex.y, quad.tl.x, quad.tl.y);
    charUVOffsetBuffer.push(
        quad.tex.x + quad.tex.w,
        quad.tex.y,
        quad.tr.x,
        quad.tr.y,
    );
    charUVOffsetBuffer.push(
        quad.tex.x + quad.tex.w,
        quad.tex.y + quad.tex.h,
        quad.br.x,
        quad.br.y,
    );
    charUVOffsetBuffer.push(
        quad.tex.x,
        quad.tex.y + quad.tex.h,
        quad.bl.x,
        quad.bl.y,
    );
    charPositionsBuffer.push(x, y, x, y, x, y, x, y);

    indexBuffer.push(0 + i, 2 + i, 1 + i);
    indexBuffer.push(2 + i, 0 + i, 3 + i);
    i += 4;
});
在頂點著色器中,把 uv 除以紋理尺寸,得到傳入片段著色器、用來取樣字形圖集的紋理座標。同時把 offset 乘上字型縮放,得到相對於錨點的偏移,最後把位置與偏移相加,得到最終的頂點位置:
v_Uv = a_UvOffset.xy / u_AtlasSize;

vec2 offset = a_UvOffset.zw * fontScale;
gl_Position = vec4((u_ProjectionMatrix
    * u_ViewMatrix
    * u_ModelMatrix
    * vec3(a_Position + offset, 1)).xy, zIndex, 1);
最後看看如何計算字形資料。上一節做完段落分段後,我們得到多行字串陣列 lines,再結合 textAlign、letterSpacing 與 fontMetrics,計算每個字元相對於錨點的位置資訊。
function layout(
    lines: string[], // after paragraph segmentation
    fontStack: string,
    lineHeight: number,
    textAlign: CanvasTextAlign,
    letterSpacing: number,
    fontMetrics: globalThis.TextMetrics & { fontSize: number },
): PositionedGlyph[] {}
這裡參考 mapbox-gl-js shaping.ts 的實作:
export type PositionedGlyph = {
    glyph: number; // charCode
    x: number;
    y: number;
    scale: number; // The scale ratio calculated according to the zoom level
    fontStack: string;
};lines.forEach((line) => {
const lineStartIndex = positionedGlyphs.length;
canvasTextMetrics.splitGraphemes(line).forEach((char) => {});
});改進
目前渲染的文字在放大時有明顯的「人工痕跡」,一個明顯原因是產生的 SDF 解析度。在 Mapbox 目前的實作中,用 SDF_SCALE 來控制它。產生的 SDF 解析度越高就越細膩,但也會帶來效能下降。
https://github.com/mapbox/mapbox-gl-js/blob/main/src/render/glyph_manager.ts#L34
選擇 SDF_SCALE 是效能與品質之間的取捨。 字形產生時間隨縮放比例呈平方成長,而當縮放高於裝置像素比時,品質提升會迅速遞減。縮放為 2 時,能以可接受的成本在 HDPI 螢幕上帶來明顯改善。
下圖展示 SDF_SCALE 取值為 1 與 4 時,放大後的比較效果:
| SDF_SCALE = 1 | SDF_SCALE = 4 |
|---|---|
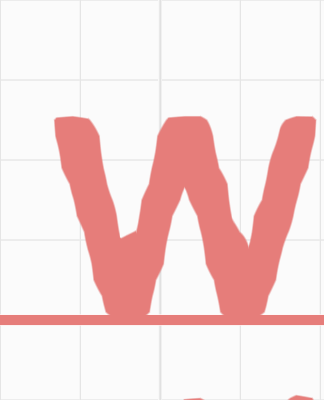 | 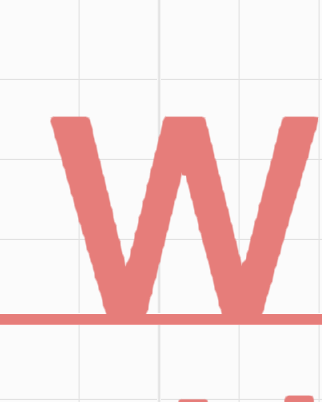 |
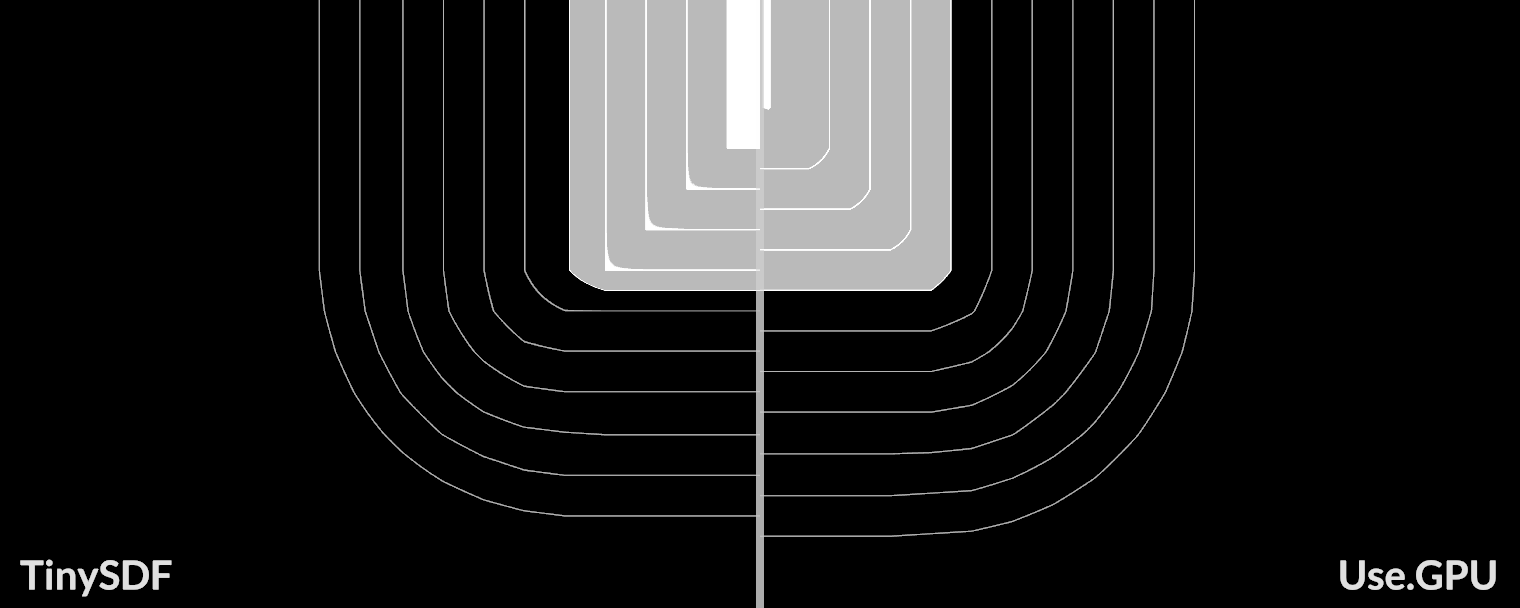
不過先不要調整 SDF 解析度。目前 tiny-sdf 的實作仍有問題。
次像素距離變換
次像素距離變換 指出 tiny-sdf 的實作有問題,並提供了改進的實作。
首先,我們用 Canvas 產生的不只是黑白 Hard mask,而是一張灰階影像:

在 tiny-sdf 的實作中,當 a 不是 1 時,處理如下:
// @see https://github.com/mapbox/tiny-sdf/blob/main/index.js#L89
if (a === 1) {
} else {
    const d = 0.5 - a; // aliased pixels
    gridOuter[j] = d > 0 ? d * d : 0;
    gridInner[j] = d < 0 ? d * d : 0;
}
MSDF
用低解析度距離場重建時,字元的轉角太過平滑,無法保持原本的銳利。現在來解決這個問題。
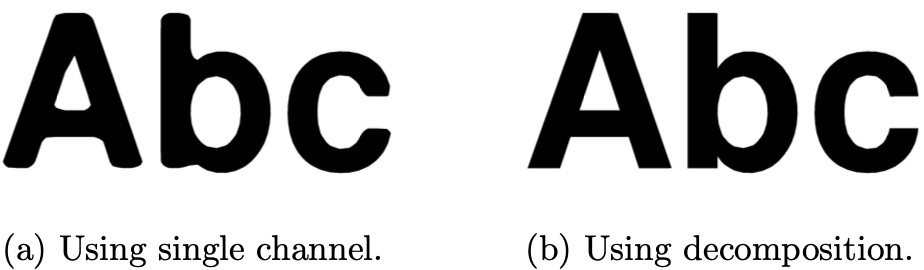
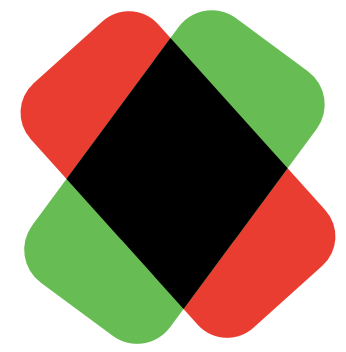
距離場可以做集合運算。下圖來自 多通道距離場的形狀分解,我們把兩個距離場分別存在點陣圖的兩個分量(R、G)中。重建時,雖然這兩個距離場在轉角處是平滑的,但可以用交集得到銳利的還原效果:
分解演算法可以參考原論文 多通道距離場的形狀分解 的 4.4 節:直接建構多通道距離場。實際使用時,作者提供了 msdfgen,可以看出 MSDF 在低解析度下效果好很多,甚至優於更高解析度的 SDF。
就產生工具而言,線上工具有 MSDF 字型產生器,命令列工具有 msdf-bmfont-xml。這些工具會同時產生 MSDF 圖集,也會產生 fnt 或 json 檔,其中包含每個字元的版面資訊,供後續繪製使用。pixi-msdf-text 是一個使用 Pixi.js 的完整範例,它用 BitmapFontLoader 載入 fnt 檔,我們的專案也參考了它的實作。
在片段著色器中用 median 重建時:
float median(float r, float g, float b) {
  return max(min(r, g), min(max(r, g), b));
}

#ifdef USE_MSDF
    vec3 s = texture(SAMPLER_2D(u_Texture), v_Uv).rgb;
    float dist = median(s.r, s.g, s.b);
#else
在下面的範例中,可以看到即使放大,字元仍然保持銳利:
font-kerning
在預先產生的 Bitmap 字型中,可以包含 kernings,用來調整固定順序中兩個字元之間的間距。
例如 https://pixijs.com/assets/bitmap-font/desyrel.xml
<kernings count="1816">
    <kerning first="102" second="102" amount="2" />
    <kerning first="102" second="106" amount="-2" />
</kernings>
包圍盒計算與版面都需要把它考慮進去。下面的範例展示了差異:
在執行期,如果想取得 font-kerning,可以參考 https://github.com/mapbox/tiny-sdf/issues/6#issuecomment-1532395796 給出的方法:
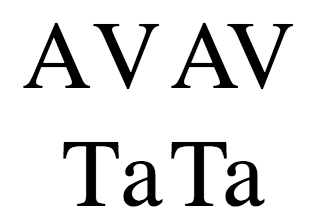
const unkernedWidth =
    tinySdf.ctx.measureText('A').width + tinySdf.ctx.measureText('V').width;
const kernedWidth = tinySdf.ctx.measureText('AV').width;
const kerning = kernedWidth - unkernedWidth; // a negative value indicates you should adjust the SDFs closer together by that much
emoji
在某些 emoji 渲染實作中,例如 EmojiEngine,採用預先產生的 emoji 圖集。但這種做法不但有紋理尺寸限制,也無法在不同平台上維持該平台特有的 emoji 外觀。因此,和 SDF 類似,我們希望在目前平台上於執行期按需產生 emoji。
這種做法和 SDF 最大的不同是,我們不能只保留 alpha 通道,而需要保留全部三個 RGB 通道,供後續的距離場重建使用。
匯出 SVG
把多行文字匯出成 SVG 時,可以使用 <tspan>,把 dy 設為測量後的行高:
<text
    x="0"
    y="0"
    dominant-baseline="ideographic"
    id="node-text-5"
    font-family="Gaegu"
    font-size="16"
    fill="black"
    transform="matrix(1,0,0,1,50,234)"
>
    <tspan x="0" dy="17.368">Abcdef</tspan>
    <tspan x="0" dy="17.368">ghijklm</tspan>
    <tspan x="0" dy="17.368">nop(ide</tspan>
</text>