Lección 15 - Renderizado de texto
El renderizado de texto es un proceso muy complejo, y Estado del renderizado de texto en 2024 ofrece una introducción muy detallada, cuya lectura es muy recomendable.
En esta lección aprenderás lo siguiente:
- Qué es TextMetrics y cómo obtenerlo en el servidor y en el navegador
- Qué es el shaping
- La segmentación de texto y el salto de línea automático, BiDi y los caracteres compuestos
- Cómo generar un atlas SDF y usarlo para dibujar
- Cómo manejar los emoji
Para los desarrolladores acostumbrados a usar Dibujar texto de Canvas 2D que ofrece el navegador, o SVG, la complejidad del renderizado de texto puede superar tu imaginación. La imagen siguiente, de Renderizado de texto moderno con Linux: visión general, muestra el flujo de datos del renderizado de texto, desde el texto hasta los glifos, la rasterización y, por último, el dibujo en pantalla. HarfBuzz, FreeType, Bidi y OpenType, que es hoy el formato de fuente más popular, se presentarán brevemente más adelante. Curiosamente, HarfBuzz es el nombre persa de «open type».

Según mi experiencia previa en proyectos de visualización web, Renderizado de texto en mapbox puede ser más instructivo en la práctica, porque no trataremos directamente con la mayoría de las herramientas de la cadena anterior. Aun así, comprender todo el proceso que sea posible te ayudará a captar la esencia del renderizado de texto.
Shaping
Empecemos por nuestra entrada: un fragmento de texto y una fuente, que se proporciona en forma de fontstack y, por tanto, como un array:
{
    "text-field": "Hey",
    "text-font": ["Open Sans Semibold", "Arial Unicode MS Bold"]
}
fontstack
Un fontstack es una lista ordenada formada por una fuente principal y una o varias fuentes de respaldo opcionales. https://docs.mapbox.com/help/troubleshooting/manage-fontstacks/
¿Qué es el shaping? La imagen siguiente, de Renderizado de texto en mapbox, en resumen, consiste en colocar en secuencia la posición de cada carácter, teniendo en cuenta, por supuesto, muchas situaciones, como encontrarse con saltos de línea:

La imagen siguiente procede de Renderizado de texto moderno con Linux: visión general

Para colocar los caracteres correctamente, necesitamos obtener TextMetrics. Incluso con la colocación más sencilla, uno al lado del otro, al menos necesitamos conocer el ancho de cada carácter. A continuación nos centramos en cómo obtenerlo en el navegador.
TextMetrics
La especificación HTML ofrece una definición de TextMetrics, dividida en conjuntos horizontal y vertical:
// @see https://html.spec.whatwg.org/multipage/canvas.html#textmetrics
interface TextMetrics {
  // x-direction
  readonly attribute double width; // advance width
  readonly attribute double actualBoundingBoxLeft;
  readonly attribute double actualBoundingBoxRight;

  // y-direction
  readonly attribute double fontBoundingBoxAscent;
  readonly attribute double fontBoundingBoxDescent;
  readonly attribute double actualBoundingBoxAscent;
  readonly attribute double actualBoundingBoxDescent;
  readonly attribute double emHeightAscent;
  readonly attribute double emHeightDescent;
  readonly attribute double hangingBaseline;
  readonly attribute double alphabeticBaseline;
  readonly attribute double ideographicBaseline;
};
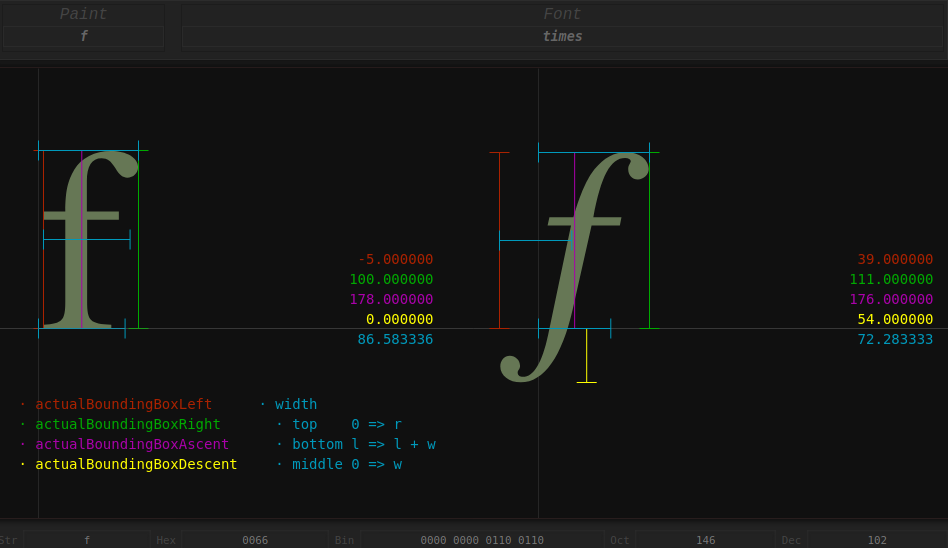
Fijémonos primero en los tres atributos horizontales. La imagen siguiente, de Diferencias entre width y actualBoundingBoxLeft(Right), muestra que hay una diferencia entre width y actualBoundingBoxLeft/Right. En resumen, este último representa el límite máximo del carácter (lo mismo ocurre con actualBoundingBoxAscent/Descent en la dirección vertical), mientras que el primero (azul) puede ser perfectamente menor que la suma del segundo (rojo + verde); por ejemplo, la f cursiva del lado derecho de la figura. Si se tiene en cuenta el font-kerning y el carácter siguiente también es f, estas dos f pueden entrelazarse una junto a la otra.
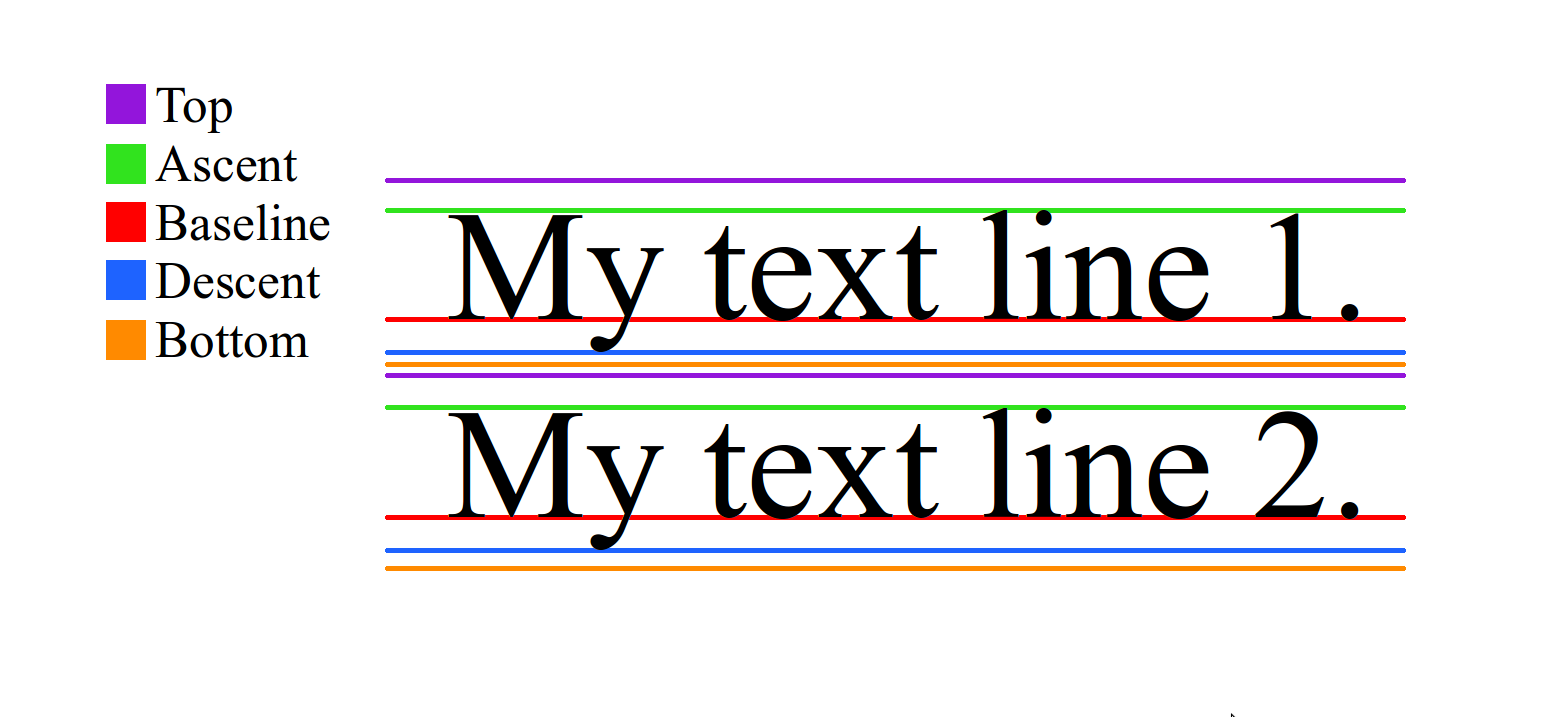
Veamos los atributos verticales. La imagen siguiente procede de Significado de top, ascent, baseline, descent, bottom y leading en FontMetrics de Android. Primero se localiza text-baseline; las propiedades que terminan en Ascent/Descent se basan en ella:
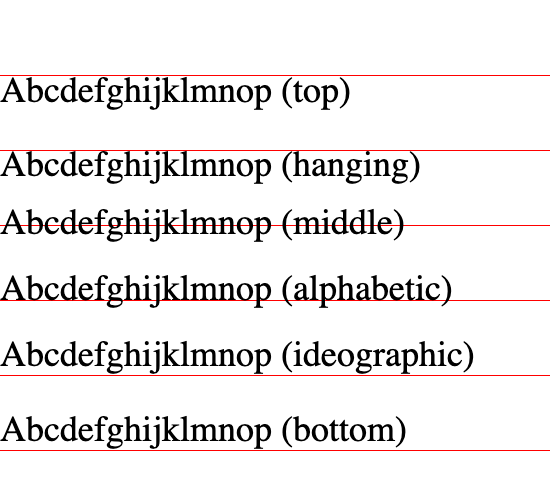
El valor de text-baseline puede consultarse en text-baseline, como se muestra en la figura de abajo. Por ejemplo, cuando se toma el valor hanging, el valor de hangingBaseline es 0, y el valor de alphabeticBaseline es la distancia de alphabetic a hanging.
Por último, fontBoundingBoxAscent/Descent es el límite máximo de la propia fuente, y actualBoundingBoxAscent/Descent es el límite máximo de la fuente cuando se dibuja de verdad, así que el primero sirve para dibujar un fondo coherente para el texto, que no aparecerá con alturas desiguales al cambiar el contenido.
measureText
¿Cómo se obtiene TextMetrics? La API de Canvas 2D ofrece measureText, pero en el uso real hay que tener en cuenta la situación en la que solo está disponible width. Tomando PIXI.TextMetrics como ejemplo, lo tiene en cuenta en la implementación: si actualBoundingBoxLeft/Right son ambos 0, se usa width:
let textMetrics = PIXI.TextMetrics.measureText('Your text', style);

// @see https://github.com/pixijs/pixijs/blob/dev/src/scene/text/canvas/CanvasTextMetrics.ts#L334
const metrics = context.measureText(text);
let metricWidth = metrics.width;
const actualBoundingBoxLeft = -metrics.actualBoundingBoxLeft;
const actualBoundingBoxRight = metrics.actualBoundingBoxRight;
let boundsWidth = actualBoundingBoxRight - actualBoundingBoxLeft;
return Math.max(metricWidth, boundsWidth);
Para los atributos relacionados con la fuente, se eligen unos pocos caracteres representativos para asegurar que se pueda medir Ascent/Descent y, si no se obtiene, se usa el valor de fontSize que el usuario introdujo a mano.
// @see https://github.com/pixijs/pixijs/blob/dev/src/scene/text/canvas/CanvasTextMetrics.ts#L779
context.font = font;
const metrics = context.measureText(
    CanvasTextMetrics.METRICS_STRING + // |ÉqÅ
        CanvasTextMetrics.BASELINE_SYMBOL, // M
);

const properties = {
    ascent: metrics.actualBoundingBoxAscent,
    descent: metrics.actualBoundingBoxDescent,
    fontSize:
        metrics.actualBoundingBoxAscent + metrics.actualBoundingBoxDescent,
};

if (fontProperties.fontSize === 0) {
    fontProperties.fontSize = style.fontSize as number;
    fontProperties.ascent = style.fontSize as number;
}
Además de usar la API de Canvas 2D, en el navegador también hay las opciones siguientes:
- opentype.js
- use-gpu usa un use-gpu-text basado en ab-glyph
- Cada vez más aplicaciones usan harfbuzzjs; consulta: Estado del renderizado de texto en 2024
El uso de HarfBuzz en la web ha ido en aumento, primero transpilado a JavaScript y, más recientemente, compilado de forma cruzada a WebAssembly mediante harfbuzzjs. Aplicaciones como Photopea, un editor de fotos en línea, lo usan así. Crowbar, de Simon Cozens, es una aplicación web de depuración del shaping de OpenType construida con la API de mensajes de buffer de HarfBuzz. Sploot es otra aplicación web de Simon, un inspector de fuentes. Prezi y Figma también usan HarfBuzz en sus aplicaciones web.
Como se afirma en Lo que HarfBuzz no hace, resolver el problema de medición de los caracteres individuales dista mucho de ser suficiente; a continuación consideramos letterSpacing.
HarfBuzz puede decirte lo ancha que es una pieza de texto ya conformada, lo que es una entrada útil para un algoritmo de justificación, pero no sabe nada de párrafos, líneas ni longitudes de línea. Tampoco ajusta el espacio entre palabras para encajarlas de forma proporcional en una línea.
letterSpacing
La API de Canvas 2D ofrece letterSpacing, que se puede usar para ajustar el espaciado entre caracteres. Lo fijamos antes de medir el texto:
measureText(
    text: string,
    letterSpacing: number,
    context: ICanvasRenderingContext2D
) {
    context.letterSpacing = `${letterSpacing}px`;
    // Omitted measurement process
}
Después, al disponer la posición de cada carácter, también hay que tenerlo en cuenta, lo que presentaremos en Generar quads.
Maquetación de párrafos
Los caracteres individuales se combinan para formar oraciones, y las oraciones forman párrafos. La imagen siguiente, de La maquetación de texto es una jerarquía laxa de segmentación, muestra la estructura jerárquica de la maquetación de texto de abajo arriba.

La API de Canvas 2D no ofrece capacidades relacionadas con párrafos en el dibujo de texto, solo la función más básica de Dibujar texto. CanvasKit, basado en Skia, ha ampliado esto y ofrece además un método drawParagraph; consulta: Shaping de texto en CanvasKit
Una de las mayores funciones que CanvasKit ofrece frente a la API de Canvas de HTML es el shaping de párrafos.
const paragraph = builder.build();
paragraph.layout(290); // width in pixels to use when wrapping text
canvas.drawParagraph(paragraph, 10, 10);
Empecemos por la segmentación de párrafos.
Segmentación de párrafos
La base más sencilla de segmentación son los saltos de línea explícitos.
const newlines: number[] = [
    0x000a, // line feed
    0x000d, // carriage return
];
Además, también hay que tener en cuenta el salto de línea automático. Al mismo tiempo, conviene que cada línea se acerque lo más posible a la misma longitud; consulta: Embellecer las etiquetas de mapa con un mejor salto de línea
const breakingSpaces: number[] = [
    0x0009, // character tabulation
    0x0020, // space
    0x2000, // en quad
    0x2001, // em quad
    0x2002, // en space
    0x2003, // em space
    0x2004, // three-per-em space
    0x2005, // four-per-em space
    0x2006, // six-per-em space
    0x2008, // punctuation space
    0x2009, // thin space
    0x200a, // hair space
    0x205f, // medium mathematical space
    0x3000, // ideographic space
];
En CJK, algunos caracteres no pueden aparecer al principio de una línea y otros no pueden aparecer al final. Por ejemplo, en chino, la mayoría de los signos de puntuación no pueden aparecer al principio de una línea. Para las reglas concretas, consulta: Reglas de salto de línea en las lenguas de Asia oriental. pixi-cjk trata estas situaciones:

Otro escenario habitual de saltos de línea automáticos es cuando se especifica un ancho máximo y el texto pasa a la línea siguiente si lo supera. Además, puedes fijar un número máximo de líneas y, cuando se supera ese límite, se aplica la propiedad text-overflow.
{
    wordWrap: true,
    wordWrapWidth: 100,
    maxLines: 3,
    textOverflow: TextOverflow.ELLIPSIS,
}
Podemos referirnos a la implementación de Pixi.js: CanvasTextMetrics
for (let i = 0; i < chars.length; i++) {
    const char = chars[i];
    const prevChar = text[i - 1];
    const nextChar = text[i + 1];
    const charWidth = calcWidth(char);

    if (currentWidth > 0 && currentWidth + charWidth > maxWidth) {
        if (currentIndex + 1 >= maxLines) {
            // 超出最大行数,添加省略号
            appendEllipsis(currentIndex);
            break;
        }

        currentIndex++;
        currentWidth = 0;
        lines[currentIndex] = '';

        if (isBreakingSpace(char)) {
            continue;
        }
    }
}
BiDi
HarfBuzz no manejará BiDi; consulta Lo que HarfBuzz no hace:
HarfBuzz no te ayudará con la bidireccionalidad.
BiDi
Soporte para manejar texto que mezcla datos de izquierda a derecha (inglés) y de derecha a izquierda (árabe o hebreo).
Por ejemplo, para este contenido mixto LTR y RTL ABCאבגDEF, tenemos que cambiar a mano el orden del texto RTL para mostrar el efecto correcto:
'ABCאבגDEF'.split(''); // ['A', 'B', 'C', 'ג' ,'ב' ,'א', 'D', 'E', 'F']Este problema no es fácil de resolver en el navegador; consulta: BiDi en Pixi.js. mapbox-gl-rtl-text y rtl-text portaron International Components for Unicode (ICU) a WASM, lo que aumenta el tamaño del bundle de JS. Sin embargo, ahora podemos usar bidi-js para manejarlo: al encontrar caracteres RTL, hay que invertirlos a mano:
import bidiFactory from 'bidi-js';

this.#bidi = bidiFactory();
const embeddingLevels = this.#bidi.getEmbeddingLevels(text);
let bidiChars = '';
for (const segment of segmentStack[0]!) {
    const { text, direction } = segment;
    bidiChars += direction === 'ltr' ? text : text.split('').reverse().join('');
}
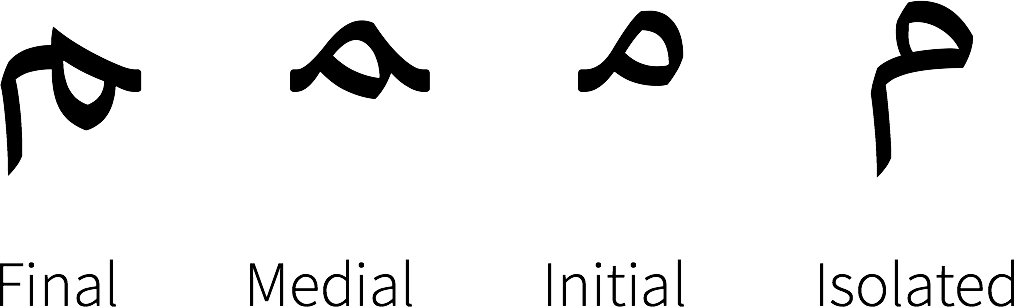
En el árabe impreso, cada carácter puede tener una forma «aislada», «inicial», «medial» y «final». Como ejemplo, aquí están las cuatro formas de la letra árabe «meem» (U+0645); consulta: Mejorar el texto árabe y hebreo en las etiquetas de mapa.
Elegimos JavaScript-Arabic-Reshaper, que es mucho más ligero en comparación con ICU.
import ArabicReshaper from 'arabic-reshaper';

if (direction === 'ltr') {
    bidiChars += text;
} else {
    bidiChars += ArabicReshaper.convertArabic(text)
        .split('')
        .reverse()
        .join('');
}
Después de resolver BiDi, ahora tenemos que abordar el problema de los caracteres compuestos. El ejemplo siguiente procede de cosmic-text, una biblioteca de procesamiento de texto multilínea implementada en Rust.
for line in BidiParagraphs::new(&text) {
    for grapheme in line.graphemes(true) {
        for c in grapheme.chars() {}
    }
}
Caracteres compuestos
No todos los caracteres están formados por un solo carácter. clusters es el término que usa HarfBuzz para manejar caracteres compuestos
En el shaping de texto, un cluster es una secuencia de caracteres que hay que tratar como una unidad única e indivisible.
Por ejemplo, los emoji lo son. Si los procesamos como un solo carácter (por ejemplo, con split('')), tanto la medición como el dibujo posterior producirán un truncamiento incorrecto:
'🌹'.length; // 2
'🌹'[0]; // '\uD83C'
'🌹'[1]; //'\uDF39'
En el navegador podemos usar una biblioteca como grapheme-splitter. El uso es el siguiente:
var splitter = new GraphemeSplitter();
// plain latin alphabet - nothing spectacular
splitter.splitGraphemes('abcd'); // returns ["a", "b", "c", "d"]
// two-char emojis and six-char combined emoji
splitter.splitGraphemes('🌷🎁💩😜👍🏳️🌈'); // returns ["🌷","🎁","💩","😜","👍","🏳️🌈"]Pero su tamaño (sigue siendo 22 kB después de la compresión) no es despreciable; consulta BundlePhobia grapheme-splitter. Por eso, en Pixi.js se usa de forma predeterminada el Intl.Segmenter propio del navegador para manejar caracteres compuestos, y esta función la admiten la mayoría de los navegadores modernos:
// @see https://github.com/pixijs/pixijs/blob/dev/src/scene/text/canvas/CanvasTextMetrics.ts#L121C19-L131C10
const splitGraphemes: (s: string) => string[] = (() => {
    if (typeof (Intl as IIntl)?.Segmenter === 'function') {
        const segmenter = new (Intl as IIntl).Segmenter();

        return (s: string) => [...segmenter.segment(s)].map((x) => x.segment);
    }

    return (s: string) => [...s];
})();
También adoptamos esta solución, que se usará más adelante al generar el SDF de los caracteres.
text-align
Implementar text-align es sencillo:
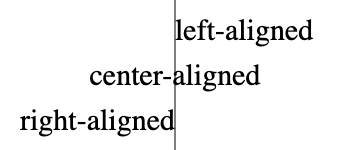
let offsetX = 0;
if (textAlign === 'center') {
    offsetX -= width / 2;
} else if (textAlign === 'right' || textAlign === 'end') {
    offsetX -= width;
}
Pero implementar la alineación vertical no es tan sencillo. text-baseline solo sirve para texto de una línea y, en muchos escenarios, queremos que todo el párrafo quede centrado. Lo presentaremos cuando hablemos más adelante de la maquetación flex.
Renderizado
La imagen siguiente muestra la posición del motor de renderizado de fuentes FreeType en el proceso:

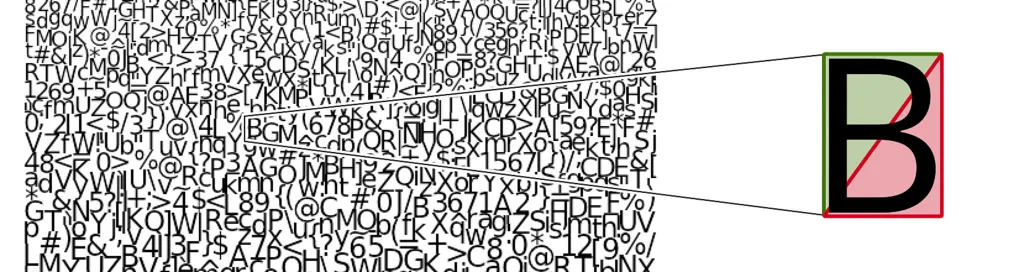
Centrémonos en las técnicas concretas de renderizado de texto. Para los caracteres latinos, con un conjunto de caracteres limitado, es perfectamente posible generar un atlas de glifos sin conexión y subirlo a la GPU en tiempo de ejecución; freetype-gl se implementa de esta manera.
El atlas de glifos es una única imagen que se subirá como textura a la GPU junto con el resto de los datos del mosaico. Aquí hay una representación visual de un atlas de glifos:
La imagen siguiente procede de: Dibujar texto con campos de distancia con signo en Mapbox GL
Pero el problema de este enfoque no vectorial es que los caracteres se vuelven muy borrosos al ampliarlos. La imagen siguiente procede de Fuentes de campo de distancia
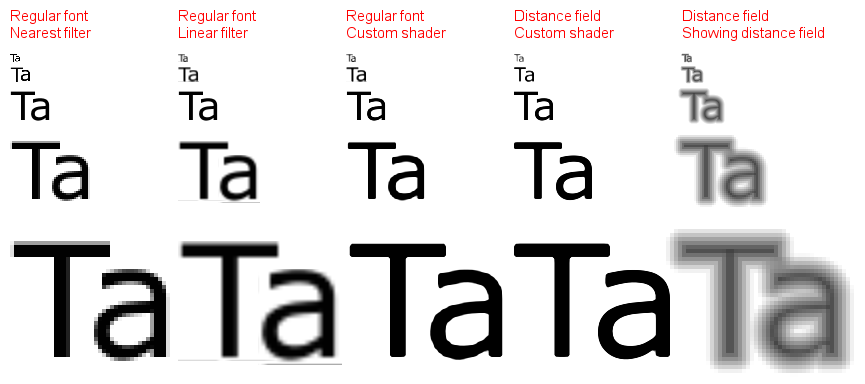
La solución dominante basada en SDF procede hoy del artículo de Valve Ampliación mejorada con prueba alfa para texturas vectoriales y efectos especiales. Las ventajas de esta solución incluyen:
- Se mantiene nítida después de escalar
- Es fácil implementar antialiasing, halo, sombras y otras funciones
Pero el problema es que los bordes no son lo bastante nítidos, aunque en escenarios de visualización la tolerancia es mayor, y también se puede optimizar con métodos como msdf. Además, el SDF tampoco puede admitir el hinting de fuentes.
Veamos primero la situación de generación de SDF para un solo carácter.
Generación de SDF
La imagen siguiente procede de msdf-atlas-gen. Nos centramos en estos dos tipos de atlas, SDF y MSDF:
| Máscara dura | Máscara suave | SDF | PSDF | MSDF | MTSDF | |
|---|---|---|---|---|---|---|
| Canales: | 1 (1 bit) | 1 | 1 | 1 | 3 | 4 |
| Antialiasing: | - | Sí | Sí | Sí | Sí | Sí |
| Escalabilidad: | - | - | Sí | Sí | Sí | Sí |
| Esquinas nítidas: | - | - | - | - | Sí | Sí |
| Efectos suaves: | - | - | Sí | - | - | Sí |
| Efectos duros: | - | - | - | Sí | Sí | Sí |
Si se permite la generación sin conexión, puedes usar msdf-atlas-gen o node-fontnik (mapbox lo usa para generar en el servidor un SDF codificado en protocol buffer). Pero, teniendo en cuenta los caracteres CJK, puedes usar tiny-sdf para la generación en tiempo de ejecución. El uso es el siguiente: después de pasar los atributos relacionados con la fuente, se obtienen datos de píxeles.
const tinySdf = new TinySDF({
    fontSize: 24,
    fontFamily: 'sans-serif',
});
const glyph = tinySdf.draw('泽'); // Contains pixel data, width and height, character metrics, etc.
Analicemos brevemente su principio de generación. Primero usa la API de Canvas2D del navegador getImageData para obtener datos de píxeles, pero al escribir hay un margen de buffer, que se tiene en cuenta para la implementación del halo.
const size = (this.size = fontSize + buffer * 4);El método de recorrido más bruto,
Para una cuadrícula bidimensional, la «distancia» del campo de distancia es la distancia euclidiana, así que la EDT (Euclidean Distance Transform, transformada de distancia euclidiana) se define como sigue. Donde
Donde la primera parte no depende de
Por tanto, solo necesitamos considerar la distancia unidimensional al cuadrado:
Si entendemos la fórmula anterior del campo de distancia unidimensional al cuadrado desde un punto de vista geométrico, en realidad es un conjunto de parábolas, y cada parábola tiene su punto más bajo en
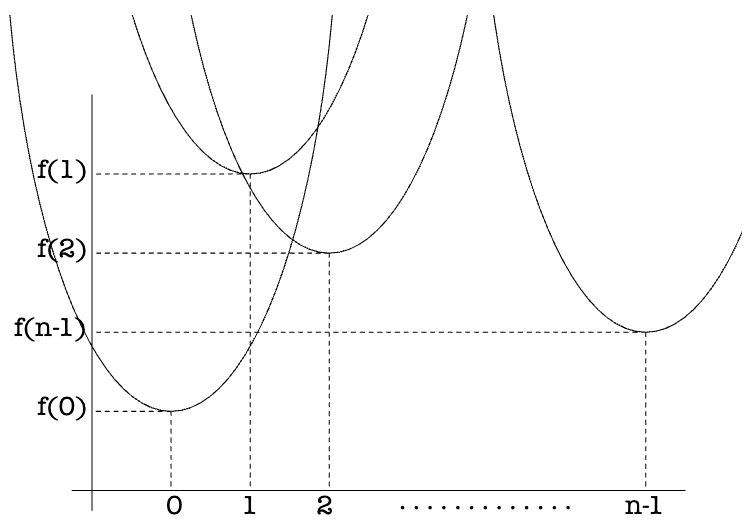
Por tanto, el límite inferior de este conjunto de parábolas, es decir, la parte de línea continua de la imagen siguiente, representa el resultado del cálculo de la EDT:
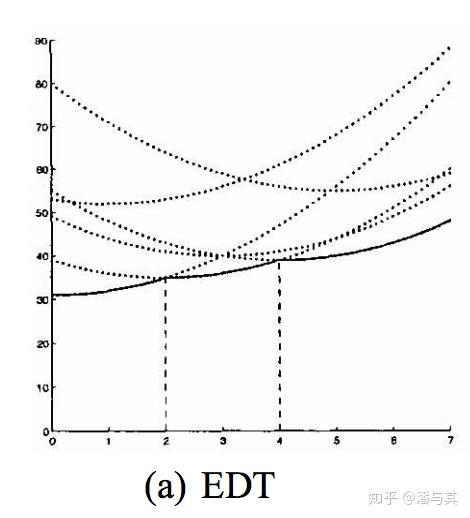
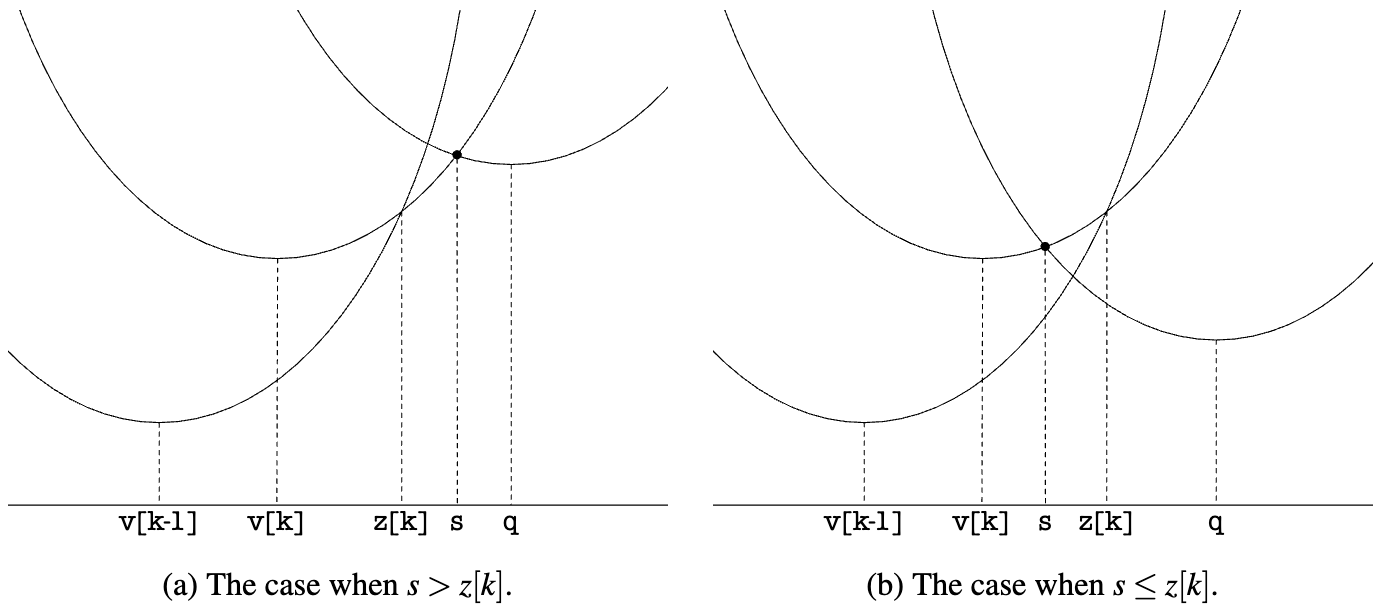
Para encontrar este límite inferior, tenemos que calcular los puntos de intersección de dos parábolas cualesquiera. Por ejemplo, para las dos parábolas
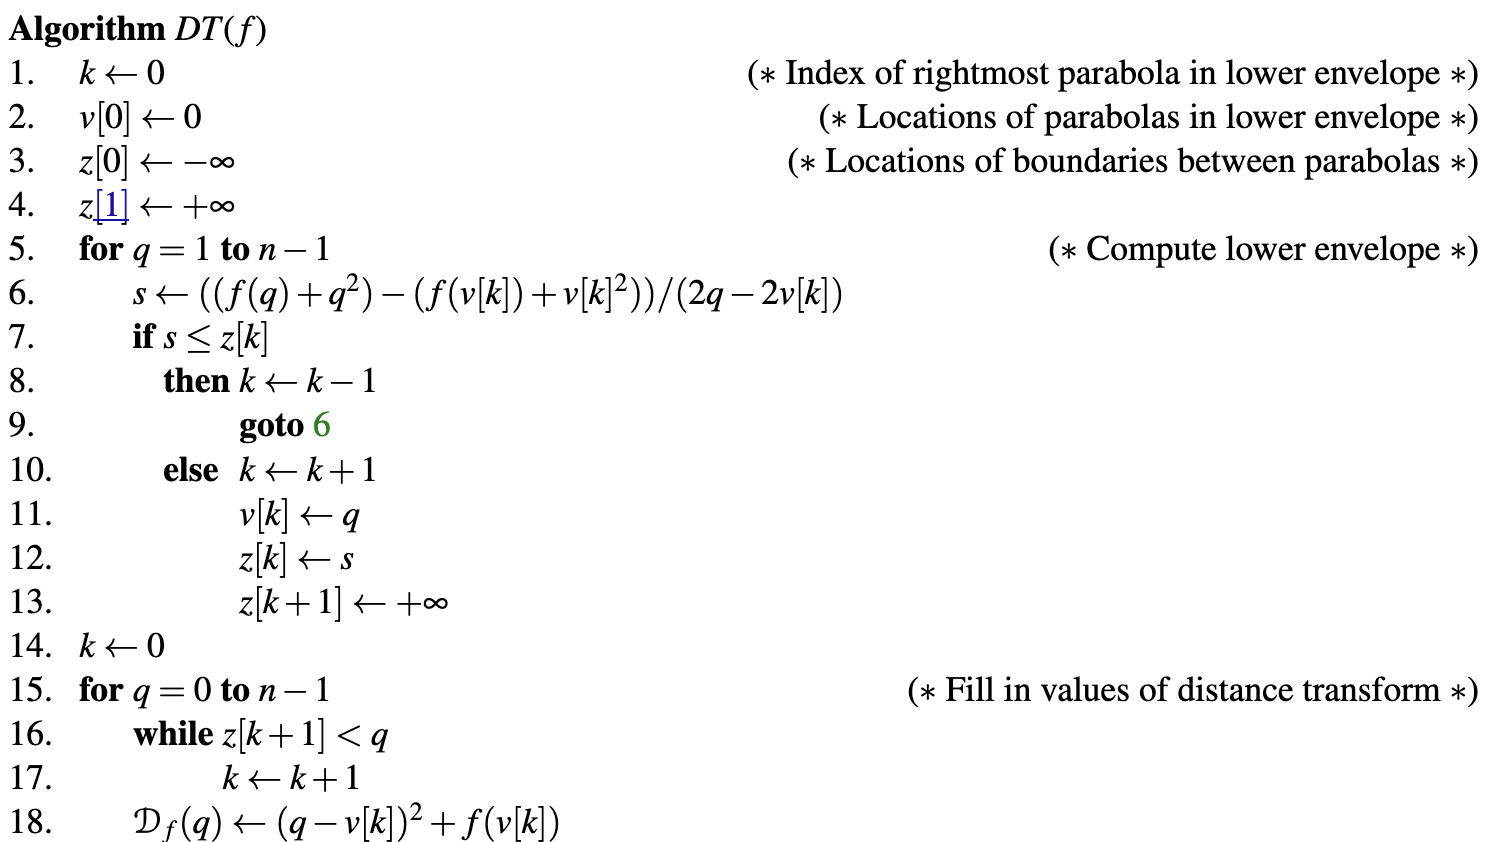
Ahora que tenemos los conocimientos para calcular la EDT 1D, guarda en
El algoritmo completo es el siguiente. tiny-sdf lo implementa (EDT 1D), e incluso los nombres de las variables coinciden:
Transformada de distancia de subpíxel presenta en detalle la idea de este algoritmo: calcula por separado el campo de distancia exterior y después combina los dos:
Para hacer un campo de distancia con signo, haces esto por separado para el interior y el exterior, y después combinas los dos como interior menos exterior, o al revés.
Empieza por lo más básico, el 1D. Primero se supone que nuestra entrada solo tiene blanco y negro, es decir, la máscara dura mencionada arriba, y se calcula primero el campo de distancia exterior:

A continuación se calcula el campo de distancia interior. I invierte O:
Por último se combinan, restando el campo de distancia interior al campo de distancia exterior:
En la implementación de tiny-sdf, el proceso de arriba corresponde a la lógica de procesamiento cuando a es 1:
// @see https://github.com/mapbox/tiny-sdf/blob/main/index.js#L85
gridOuter.fill(INF, 0, len);
gridInner.fill(0, 0, len);

for (let y = 0; y < glyphHeight; y++) {
    for (let x = 0; x < glyphWidth; x++) {
        if (a === 1) {
            // fully drawn pixels
            gridOuter[j] = 0;
            gridInner[j] = INF;
        } else {
        }
    }
}

edt(outer, 0, 0, wp, hp, wp, this.f, this.z, this.v);
edt(inner, pad, pad, w, h, wp, this.f, this.z, this.v);

for (let i = 0; i < np; i++) {
    const d = Math.sqrt(outer[i]) - Math.sqrt(inner[i]);
    out[i] = Math.max(
        0,
        Math.min(255, Math.round(255 - 255 * (d / this.radius + this.cutoff))),
    );
}
Para el cálculo de la EDT 2D, como presentamos al principio de esta sección, se descompone en dos pasadas de distancia al cuadrado 1D y, al final, se obtiene la raíz cuadrada. Es parecido al efecto de desenfoque gaussiano del posprocesado:
Igual que una transformada de Fourier, puedes aplicarla a imágenes 2D aplicándola en horizontal a cada fila X y después en vertical a cada columna Y (o al revés).
Aquí también se puede ver directamente que, para una cuadrícula de tamaño height * width, la complejidad es
// @see https://github.com/mapbox/tiny-sdf/blob/main/index.js#L110
function edt(data, width, height, f, d, v, z) {
    // Pass 1
    for (var x = 0; x < width; x++) {
        for (var y = 0; y < height; y++) {
            f[y] = data[y * width + x];
        }
        // Fix x and calculate 1D distance squared
        edt1d(f, d, v, z, height);
        for (y = 0; y < height; y++) {
            data[y * width + x] = d[y];
        }
    }
    // Pass 2
    for (y = 0; y < height; y++) {
        for (x = 0; x < width; x++) {
            f[x] = data[y * width + x];
        }
        edt1d(f, d, v, z, width);
        for (x = 0; x < width; x++) {
            // Take the square root to get the Euclidean distance
            data[y * width + x] = Math.sqrt(d[x]);
        }
    }
}
Resuelto el problema de la generación de SDF de un solo carácter, el paso siguiente es fusionar todos los SDF de caracteres en una imagen grande, que más adelante se usará como textura.
Atlas de glifos
El SDF individual tiene que fusionarse en una imagen grande para usarse después como textura, de forma parecida a un CSS Sprite. Este tipo de problema se llama: Problema de empaquetado en contenedores, meter una caja pequeña en una caja grande y usar el espacio de forma razonable para reducir los huecos. Elegimos potpack. Este algoritmo puede obtener un resultado lo más cercano posible a un cuadrado; la desventaja es que, después de generar la disposición, no se permite modificarla, solo volver a generarla.
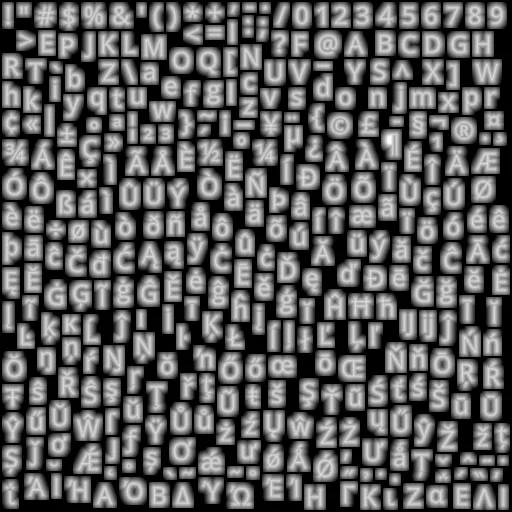
El atlas guarda los glifos que usa en ese momento un lote de texto. Su primera construcción también incluye un glifo de espacio, de modo que el texto vacío tenga métricas válidas. Un carácter nuevo, o un cambio de familia, peso, estilo o relleno de la fuente, puede reconstruir el atlas; cambiar solo el tamaño de fuente lo reutiliza. Generar únicamente los caracteres visibles evita hornear 96 glifos ASCII sin usar para cada estilo de texto al importar un SVG con muchas etiquetas.
Esta textura solo necesita usar un canal. Si es WebGL, puedes usar el formato gl.ALPHA, pero en WebGPU no hay un formato correspondiente. Por eso usamos el formato Format.U8_R_NORM, que es gl.LUMINANCE en WebGL y r8unorm en WebGPU.
this.glyphAtlasTexture = device.createTexture({
    ...makeTextureDescriptor2D(Format.U8_R_NORM, atlasWidth, atlasHeight, 1),
    pixelStore: {
        unpackFlipY: false,
        unpackAlignment: 1,
    },
});
Después, en el shader, la distancia con signo se obtiene del canal r:
uniform sampler2D u_SDFMap; // glyph atlas
varying vec2 v_UV;

float dist = texture2D(u_SDFMap, v_UV).r;
Lo anterior es la lógica de dibujo en el shader de fragmentos. Veamos cómo calcular la posición de cada carácter que se pasa al shader de vértices.
Generar quads
Primero tenemos que convertir cada glifo, a partir de los datos del glifo, en dos triángulos (lo que se llama «quad»), que contienen cuatro vértices:
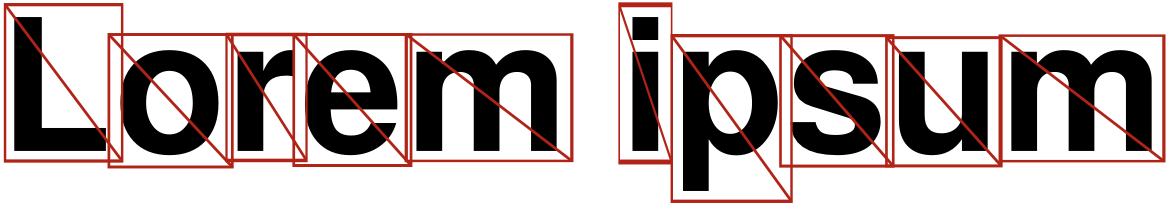
Los datos simplificados del glifo, SymbolQuad, se definen así:
// @see https://github.com/mapbox/mapbox-gl-js/blob/main/src/symbol/quads.ts#L42
export type SymbolQuad = {
    tl: Point; // The coordinates of the four vertices in local coordinates
    tr: Point;
    bl: Point;
    br: Point;
    tex: {
        x: number; // Texture coordinates
        y: number;
        w: number;
        h: number;
    };
};
Para cada dato de glifo, se divide en cuatro vértices, donde uv y offset se combinan en un solo stride y después se accede a ellos en el shader de vértices mediante a_UvOffset:
glyphQuads.forEach((quad) => {
    charUVOffsetBuffer.push(quad.tex.x, quad.tex.y, quad.tl.x, quad.tl.y);
    charUVOffsetBuffer.push(
        quad.tex.x + quad.tex.w,
        quad.tex.y,
        quad.tr.x,
        quad.tr.y,
    );
    charUVOffsetBuffer.push(
        quad.tex.x + quad.tex.w,
        quad.tex.y + quad.tex.h,
        quad.br.x,
        quad.br.y,
    );
    charUVOffsetBuffer.push(
        quad.tex.x,
        quad.tex.y + quad.tex.h,
        quad.bl.x,
        quad.bl.y,
    );
    charPositionsBuffer.push(x, y, x, y, x, y, x, y);

    indexBuffer.push(0 + i, 2 + i, 1 + i);
    indexBuffer.push(2 + i, 0 + i, 3 + i);
    i += 4;
});
En el shader de vértices, se divide uv entre el tamaño de la textura para obtener las coordenadas de textura que se pasan al shader de fragmentos para muestrear el atlas de glifos. Al mismo tiempo, se multiplica el offset por la escala de la fuente para obtener el desplazamiento respecto al punto de anclaje y, por último, se suman la posición y el offset para obtener la posición final del vértice:
v_Uv = a_UvOffset.xy / u_AtlasSize;

vec2 offset = a_UvOffset.zw * fontScale;
gl_Position = vec4((u_ProjectionMatrix
    * u_ViewMatrix
    * u_ModelMatrix
    * vec3(a_Position + offset, 1)).xy, zIndex, 1);
Por último, veamos cómo calcular los datos del glifo. Después de la segmentación de párrafos de la sección anterior, obtuvimos un array de cadenas de varias líneas, lines, que se combina con textAlign, letterSpacing y fontMetrics para calcular la información de posición de cada carácter respecto al punto de anclaje.
function layout(
    lines: string[], // after paragraph segmentation
    fontStack: string,
    lineHeight: number,
    textAlign: CanvasTextAlign,
    letterSpacing: number,
    fontMetrics: globalThis.TextMetrics & { fontSize: number },
): PositionedGlyph[] {}
Aquí nos referimos a la implementación de mapbox-gl-js shaping.ts:
export type PositionedGlyph = {
    glyph: number; // charCode
    x: number;
    y: number;
    scale: number; // The scale ratio calculated according to the zoom level
    fontStack: string;
};lines.forEach((line) => {
const lineStartIndex = positionedGlyphs.length;
canvasTextMetrics.splitGraphemes(line).forEach((char) => {});
});Mejoras
El texto que se renderiza ahora tiene «huellas artificiales» evidentes al ampliarlo. Una razón clara es la resolución del SDF generado. En la implementación actual de Mapbox, se usa SDF_SCALE para controlarla: cuanto mayor es la resolución del SDF generado, más delicado es, pero también supone una caída del rendimiento.
https://github.com/mapbox/mapbox-gl-js/blob/main/src/render/glyph_manager.ts#L34
La elección de SDF_SCALE es un equilibrio entre rendimiento y calidad. El tiempo de generación de glifos crece de forma cuadrática con la escala, mientras que las mejoras de calidad caen con rapidez cuando la escala es mayor que la relación de píxeles del dispositivo. La escala de 2 consigue mejoras notables en pantallas HDPI a un coste aceptable.
La imagen siguiente muestra el efecto comparativo al hacer zoom con valores de SDF_SCALE de 1 y 4:
| SDF_SCALE = 1 | SDF_SCALE = 4 |
|---|---|
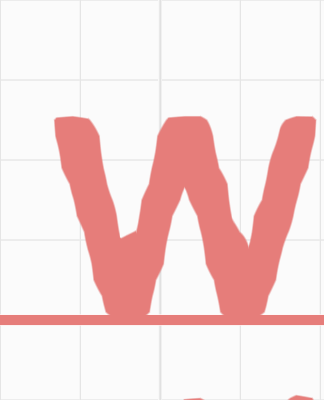 | 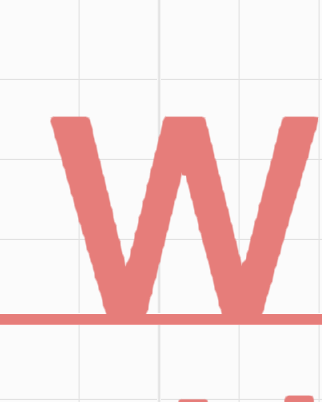 |
Pero, primero, no ajustemos la resolución del SDF. La implementación actual de tiny-sdf todavía tiene problemas.
Transformada de distancia de subpíxel
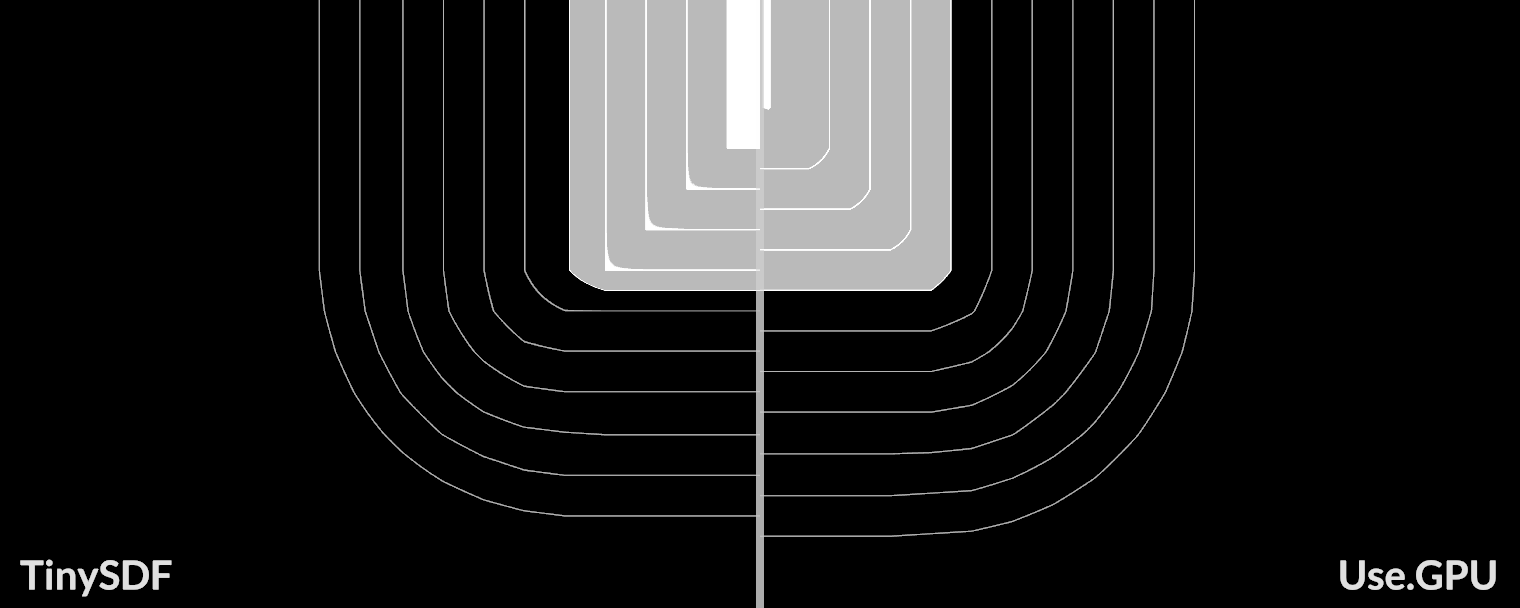
Transformada de distancia de subpíxel señala que hay problemas en la implementación de tiny-sdf y ofrece una implementación mejorada.
Primero, usamos Canvas para generar no solo una máscara dura en blanco y negro, sino una imagen en escala de grises:

En la implementación de tiny-sdf, cuando a no es 1, se procesa así:
// @see https://github.com/mapbox/tiny-sdf/blob/main/index.js#L89
if (a === 1) {
} else {
    const d = 0.5 - a; // aliased pixels
    gridOuter[j] = d > 0 ? d * d : 0;
    gridInner[j] = d < 0 ? d * d : 0;
}
MSDF
Cuando se usa un campo de distancia de baja resolución para la reconstrucción, las esquinas de los caracteres quedan demasiado suaves y no pueden mantener su nitidez original. Resolvamos ahora este problema.
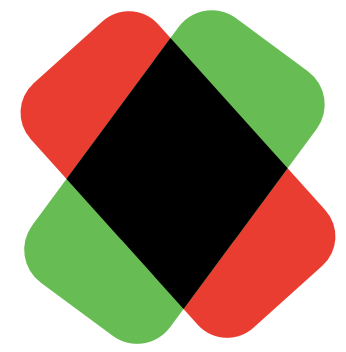
El campo de distancia se puede someter a operaciones de conjuntos. La imagen siguiente procede de Descomposición de formas para campos de distancia multicanal: guardamos los dos campos de distancia en dos componentes del mapa de bits (R, G), respectivamente. Al reconstruir, aunque estos dos campos de distancia son suaves en las esquinas, la intersección se puede usar para obtener un efecto de restauración nítido:
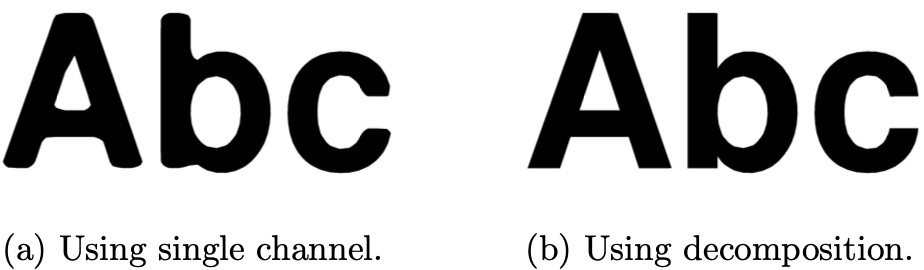
El algoritmo de descomposición puede consultarse en el artículo original Descomposición de formas para campos de distancia multicanal, en la sección 4.4: Direct multi-channel distance field construction. En el uso real, el autor ofrece msdfgen. Se puede ver que MSDF tiene un efecto mucho mejor a baja resolución, incluso mejor que un SDF de mayor resolución.
En cuanto a las herramientas de generación, entre las herramientas en línea está Generador de fuentes MSDF, y entre las herramientas de CLI está msdf-bmfont-xml. Estas herramientas generan al mismo tiempo un atlas MSDF y también un archivo fnt o json, que contiene la información de disposición de cada carácter para el dibujo posterior. pixi-msdf-text es un ejemplo completo que usa Pixi.js, que usa BitmapFontLoader para cargar el archivo fnt, y nuestro proyecto también toma como referencia su implementación.
Al reconstruir con median en el shader de fragmentos:
float median(float r, float g, float b) {
  return max(min(r, g), min(max(r, g), b));
}

#ifdef USE_MSDF
    vec3 s = texture(SAMPLER_2D(u_Texture), v_Uv).rgb;
    float dist = median(s.r, s.g, s.b);
#else
En el ejemplo de abajo, puedes ver que los caracteres se mantienen nítidos incluso al hacer zoom:
font-kerning
En las fuentes de mapa de bits pregeneradas se pueden incluir kernings, que ajustan el espaciado entre dos caracteres en una secuencia fija.
Por ejemplo https://pixijs.com/assets/bitmap-font/desyrel.xml
<kernings count="1816">
    <kerning first="102" second="102" amount="2" />
    <kerning first="102" second="106" amount="-2" />
</kernings>
Tanto el cálculo de la caja delimitadora como la maquetación tienen que tenerlo en cuenta. El ejemplo siguiente muestra las diferencias:
En tiempo de ejecución, si queremos obtener font-kerning, podemos referirnos a la forma que da https://github.com/mapbox/tiny-sdf/issues/6#issuecomment-1532395796:
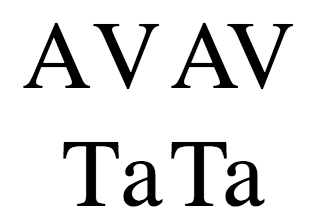
const unkernedWidth =
    tinySdf.ctx.measureText('A').width + tinySdf.ctx.measureText('V').width;
const kernedWidth = tinySdf.ctx.measureText('AV').width;
const kerning = kernedWidth - unkernedWidth; // a negative value indicates you should adjust the SDFs closer together by that much
emoji
En algunas implementaciones de renderizado de emoji, como EmojiEngine, se usa un enfoque de atlas de emoji pregenerado. Sin embargo, este enfoque no solo tiene limitaciones de tamaño de textura, sino que tampoco puede mantener el aspecto de emoji propio de cada plataforma. Por eso, de forma parecida al SDF, queremos generar los emoji bajo demanda, en tiempo de ejecución, en la plataforma actual.
La mayor diferencia entre este enfoque y el SDF es que no podemos conservar solo el canal alfa, sino que necesitamos conservar los tres canales RGB para la reconstrucción posterior del campo de distancia.
Exportar SVG
Al exportar texto de varias líneas a SVG, puedes usar <tspan>, fijando dy a la altura de línea después de la medición:
<text
    x="0"
    y="0"
    dominant-baseline="ideographic"
    id="node-text-5"
    font-family="Gaegu"
    font-size="16"
    fill="black"
    transform="matrix(1,0,0,1,50,234)"
>
    <tspan x="0" dy="17.368">Abcdef</tspan>
    <tspan x="0" dy="17.368">ghijklm</tspan>
    <tspan x="0" dy="17.368">nop(ide</tspan>
</text>
Lectura adicional
- Estado del renderizado de texto en 2024
- Fuentes de campo de distancia con signo: conceptos básicos
- Enfoques para un renderizado de texto robusto en tiempo real en threejs (y WebGL en general)
- Renderizado de texto escalable y sencillo en la GPU
- Navegador de visualización de texto
- Visión general del texto en Rive
- Renderizado de texto sin texturas
- La maquetación de texto es una jerarquía laxa de segmentación
- Recorrido de extremo a extremo de la maquetación y el renderizado de texto
- Renderizado de texto en mapbox
- Renderizar texto nítido en la GPU
- Localización, idiomas y escucha
- Idiomas RTL en Figma