Bidirectional edges
Two-way links: o--o, <-->, x--x.
flowchart LR
  A o--o B
  B <--> C
C x--x DEn Lección 35 - Renderizado basado en teselas usamos el renderizador vello, basado en compute shaders de WebGPU. En esta lección probaremos un enfoque de iluminación global que también se basa en compute shaders, y lo integraremos en la canalización de renderizado existente.
Paste while the canvas is focused to use the same styling as the demo above (dark theme, Gaegu font, etc.).
Two-way links: o--o, <-->, x--x.
flowchart LR
A o--o B
B <--> C
C x--x DMindmap
mindmap
  root((mindmap))
    Origins
      Long history
      ::icon(fa fa-book)
      Popularisation
        British popular psychology<br/> author Tony Buzan
    Research
      On effectiveness<br/>and features
      On Automatic creation
        Uses
            Creative techniques
            Strategic planning
            Argument mapping
    Tools
      Pen and paper
MermaidNested composite states with inner states.
stateDiagram-v2
    [*] --> Idle
    Idle --> Active: Start
Active --> [*]Actors and messages; paste to render on the canvas.
sequenceDiagram
  Alice->>John: Hello John, how are you?
  John-->>Alice: Great!
  Alice-)John: See you later!
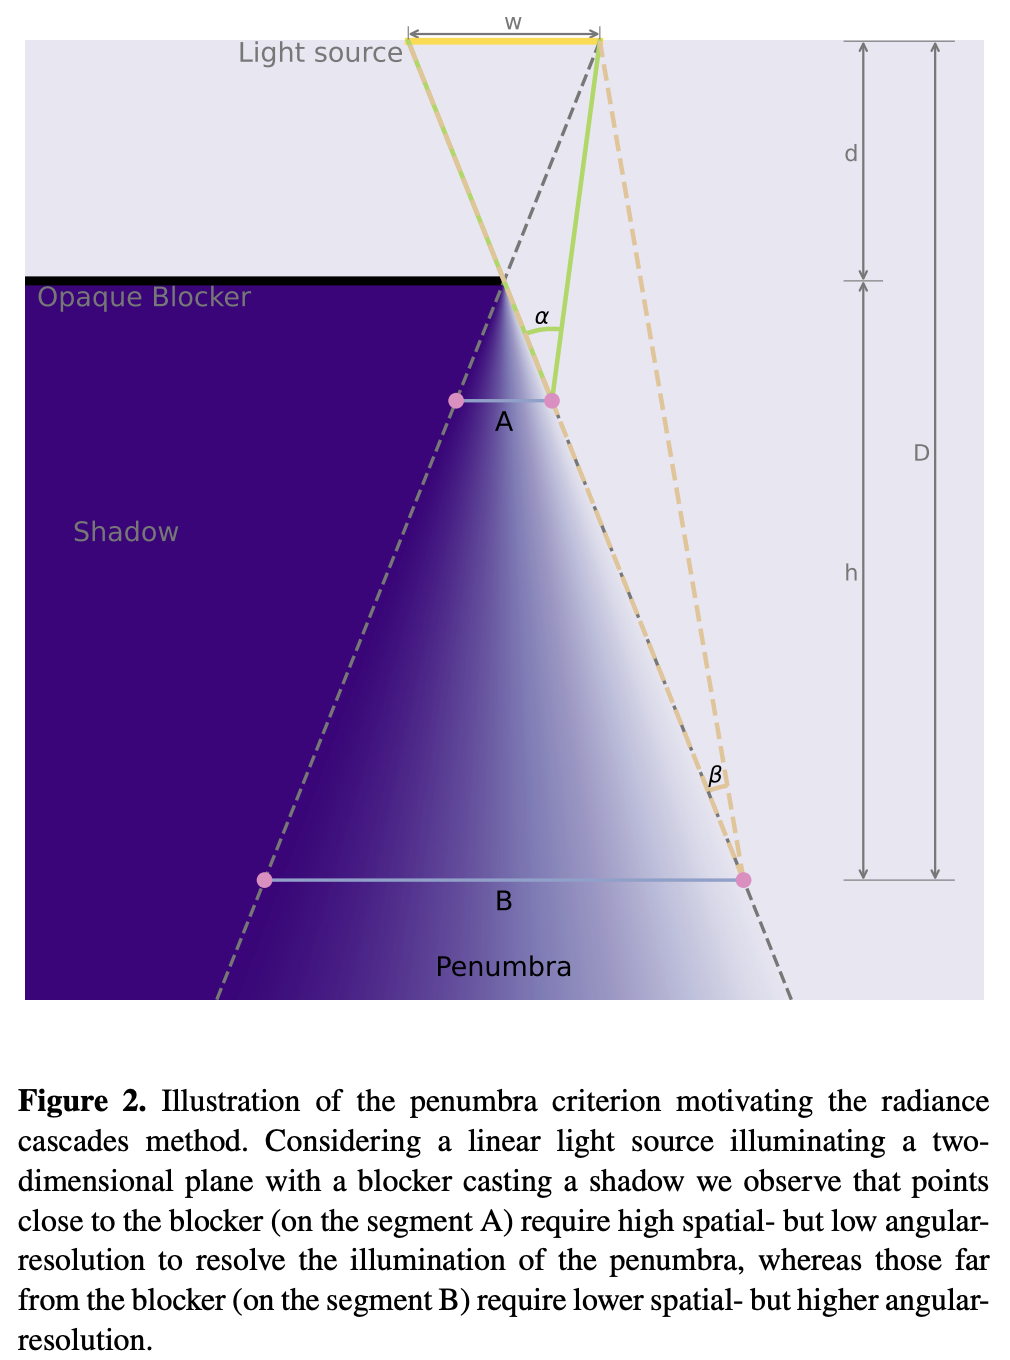
Para una explicación completa de la teoría, consulta: Fundamentals of Radiance Cascades
Lo que hemos observado es que, cuanto más lejos estamos del objeto más cercano de la escena:
- Menos resolución espacial necesitamos. (p. ej., mayor puede ser la separación entre sondas)
- Más resolución angular necesitamos. (p. ej., más rayos necesitamos por sonda)
La canalización general es:
let mut rc_enc = device_handle
    .device
    .create_command_encoder(&wgpu::CommandEncoderDescriptor {
        label: Some("rc_gi"),
    });
rp.encode_distance_pass();
rp.encode_rc_cascade_passes();
rp.encode_rc_mipmap();
rp.encode_rc_apply();
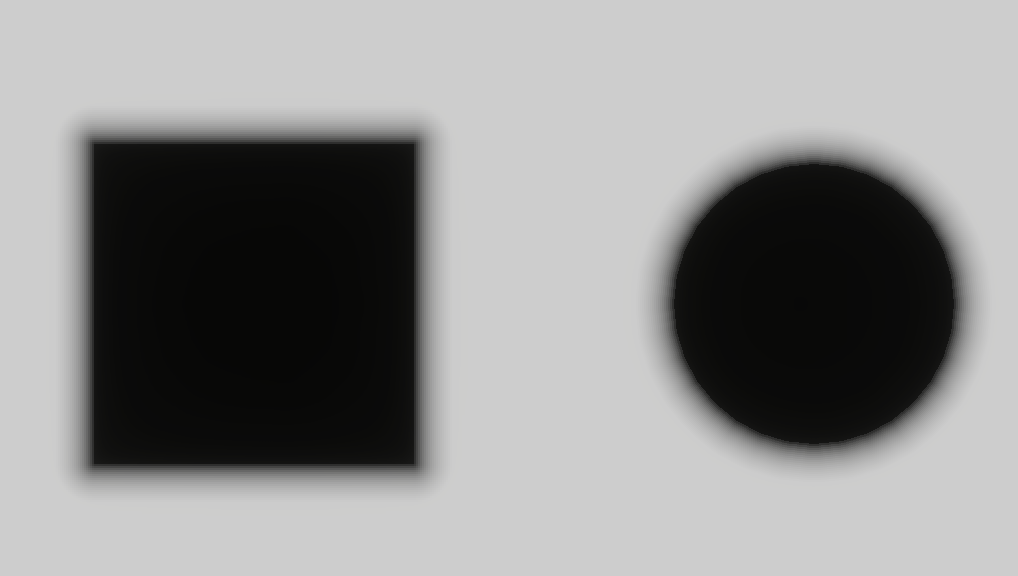
device_handle.queue.submit([rc_enc.finish()]);Empezamos por la geometría analítica. En Lección 2 - Dibujar un círculo y Lección 9 - Dibujar elipses y rectángulos ya presentamos los SDF de círculos, elipses y rectángulos. La distancia es 0 en los límites de la forma y en su interior. La figura de abajo lo visualiza en escala de grises, y mapea la distancia en bruto a [0,1] con saturate(d * DIST_FIELD_VIZ_SCALE):
Para generar la textura del campo de distancias, el shader de vértices sigue usando un triángulo a pantalla completa (parecido a nuestros pases de posprocesado anteriores). prims guarda la geometría primitiva básica de la escena, así que sdf_prim puede evaluar campos de distancia analíticos. El resultado final se escribe en rc_dist, una textura de todo el lienzo en formato R16F que almacena la distancia sin signo.
@group(0) @binding(0) var<uniform> header: DistHeader;
@group(0) @binding(1) var<storage, read> prims: array<GpuRcPrim>;

@fragment
fn dist_fs(i: VsOut) -> @location(0) vec4<f32> {
  var d = 1e6;
  let n = header.count;
  for (var i = 0u; i < 64u; i = i + 1u) {
    if i >= n { break; }
    d = min(d, sdf_prim(p_canvas, prims[i]));
  }
  // d is union SDF: inside <0, outside >0, boundary ~=0. R stores max(d,0): 0 inside and on edges, positive outside as distance to boundary.
  return vec4(max(d, 0.0), 0.0, 0.0, 1.0);
}
Por ahora solo admitimos Rect, Ellipse, Line y Polyline. Para otros SDF, consulta distfunctions2d.
La implementación de bevy_radiance_cascades usa el Jump Flood Algorithm (JFA), un método paralelo para generar campos de distancia. La idea central es propagar la información por toda la cuadrícula en log₂(N) rondas, con «pasos de salto» que decrecen de forma exponencial.
texture_2d<u32> del JFA (guarda las coordenadas de la semilla).Así, la marcha de rayos puede dar pasos grandes y seguros hasta la superficie siguiente, en lugar de usar pasos fijos diminutos.
Fundamentals of Radiance Cascades
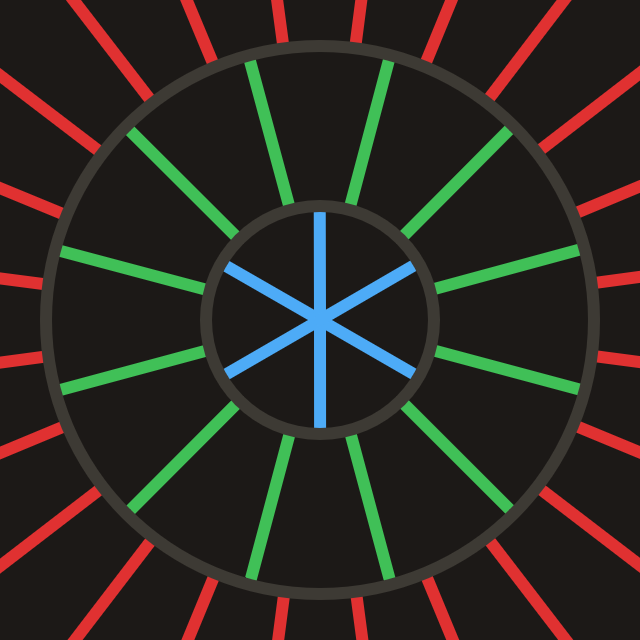
Una cascada es, en esencia, una cuadrícula de sondas en la que todas las sondas tienen las mismas propiedades. (p. ej., número de intervalos, longitud del intervalo y separación entre sondas)
Cada Probe se estructura así. Al subirlo a la GPU con alineación std140, hay que tener en cuenta el padding:
pub struct Probe {
    pub width: u32, // texel footprint per probe and ray count (angular discretization)
    pub start: f32, // where this ray segment starts from the probe center
    pub range: f32, // how far this cascade traces along the ray from start
}

pub fn probe_for_cascade(c: u32, resolution_factor: u32, interval0: f32) -> Probe {
    let width = 1u32 << (c + resolution_factor);
    let start = interval0 * (1.0 - 4.0_f32.powi(c as i32)) / -3.0;
    let range = interval0 * 4.0_f32.powi(c as i32);
    Probe {
        width,
        start,
        range,
    }
}
Calcula el número de cascadas necesario a partir de la longitud de la diagonal del lienzo:
pub fn cascade_count_for_gi_size(gi_w: u32, gi_h: u32) -> usize {
    let diag = ((gi_w * gi_w + gi_h * gi_h) as f32).sqrt();
    cascade_count_for_diagonal(diag, RC_INTERVAL0, RC_MAX_CASCADES).max(1)
}

pub const RC_INTERVAL0: f32 = 2.0;
pub const RC_MAX_CASCADES: usize = 16;
Asigna los uniforms de Probe al inicializar el lienzo:
for c in 0..cascade_count {
    let p = probe_for_cascade(c as u32, RC_RESOLUTION_FACTOR, RC_INTERVAL0);
    let slot = ProbeUniformSlotPadded::from_probe(&p);
    queue.write_buffer(
        &self.rc_probe_dynamic_buf,
        (c * PROBE_UNIFORM_STRIDE) as u64,
        bytemuck::bytes_of(&slot),
    );
}La planificación en el lado de la CPU se divide en dos canalizaciones y necesita dos texturas: rc_ping_a y rc_ping_b.
let rc_usage =
    TextureUsages::STORAGE_BINDING | TextureUsages::TEXTURE_BINDING | TextureUsages::COPY_SRC;
let (rc_a, rc_a_view) = mk_sz(
    device,
    "rc_ping_a",
    TextureFormat::Rgba16Float,
    rc_usage,
    gi_width,
    gi_height,
);
// rc_ping_b is the same
La primera canalización lee rc_ping_a y escribe rc_ping_b, y empieza por el segmento más lejano.
let mut pass = encoder.begin_compute_pass(&ComputePassDescriptor {
    label: Some("radiance_cascades_first_pass"),
    timestamp_writes: None,
});
pass.set_pipeline(&self.rc_cascade_first_pipeline);
pass.set_bind_group(0, &radiance_cascades_10, &[first_offset]);
pass.dispatch_workgroups(gw, gh, 1);
La segunda canalización alterna los bind groups radiance_cascades_01 / 10 para el ping-pong (las escrituras en rc_ping_a y rc_ping_b se turnan). Después fusiona nivel a nivel hacia un c menor, y en cada paso usa el desplazamiento de Probe que corresponde.
let mut merge_pass = encoder.begin_compute_pass(&ComputePassDescriptor {
    label: Some("radiance_cascades_merge_passes"),
    timestamp_writes: None,
});
merge_pass.set_pipeline(&self.rc_cascade_merge_pipeline);
for pass_i in 1..cascade_count {
    let cascade_idx = cascade_count - 1 - pass_i;
    let dyn_off = (cascade_idx * PROBE_UNIFORM_STRIDE) as u32;
    let merge_idx = pass_i - 1;
    let bg = if merge_idx % 2 == 0 {
        &radiance_cascades_01
    } else {
        &radiance_cascades_10
    };
    merge_pass.set_bind_group(0, bg, &[dyn_off]);
    merge_pass.dispatch_workgroups(gw, gh, 1);
}
Tanto el primer pase como los pases de cómputo de ping-pong siguientes usan la misma lógica de despacho de rayos.
@compute @workgroup_size(8, 8, 1)
fn rc_cascade_first(@builtin(global_invocation_id) gid: vec3<u32>) {
  radiance_dispatch(0u, gid);
}

@compute @workgroup_size(8, 8, 1)
fn rc_cascade_merge(@builtin(global_invocation_id) gid: vec3<u32>) {
  radiance_dispatch(1u, gid);
}Cada hilo del compute shader se ocupa de un téxel de la textura de cascada de GI:
width².start a lo largo del rayo para obtener el punto de inicio de la marcha de rayos.Dentro de un bloque de sonda, téxeles distintos representan direcciones distintas. El bloque empaqueta width² muestras direccionales. El vídeo explicativo de abajo procede de Fundamentals of Radiance Cascades:
let probe_texel = vec2<u32>(base_coord.x % probe_w, base_coord.y % probe_w);

// Flatten 2D local coords into ray IDs in 0 … probe_w²-1.
let ray_index = probe_texel.x + probe_texel.y * probe_w;
let ray_count = probe_w * probe_w;

// Uniformly split [0, 2π) into ray_count directions.
// +0.5 samples the center of each angular sector.
let ray_angle = (f32(ray_index) + 0.5) / f32(ray_count) * PI2;
let ray_dir = normalize(vec2(cos(ray_angle), sin(ray_angle)));

// Probe row/column index this texel belongs to.
let probe_cell = vec2<u32>(base_coord.x / probe_w, base_coord.y / probe_w);
// Top-left coordinate of this probe in GI texture.
let probe_coord = vec2<u32>(probe_cell.x * probe_w, probe_cell.y * probe_w);
// Probe center in GI texture.
let probe_coord_center = probe_coord + vec2<u32>(probe_w / 2u, probe_w / 2u);
// Probe center in full resolution.
let center_full = vec2<f32>(probe_coord_center) * rs.gi_scale;
Si no se encuentra un impacto y la fusión está activada, suma la radiancia interpolada de la cascada superior mediante merge().
@group(0) @binding(5) var tex_radiance_cascades_destination: texture_storage_2d<rgba16float, write>;

fn radiance_dispatch(merge_flag: u32, gid: vec3<u32>) {
  // ...

  // Start from center + ray_dir * probe.start, not exactly at center.
  // Inner cascades already cover near field; this cascade handles farther range only.
  let origin = center_full + ray_dir * ru.probe_start;
  var color = raymarch(origin, ray_dir, ru.probe_range);
  if merge_flag != 0u && color.a != 1.0 {
    color = color + merge(probe_cell, ray_index);
  }
  textureStore(tex_radiance_cascades_destination, ...);
}Para cada rayo que parte de un píxel y avanza en una dirección, damos como máximo MAX_RAYMARCH pasos. En cada paso muestreamos el campo de distancias ya generado, tex_dist_field, y avanzamos dist. Si la distancia es < EPSILON, lo tratamos como un impacto con una superficie (o como estar dentro de la geometría) y muestreamos tex_main de forma directa para obtener el color.
fn raymarch(origin: vec2<f32>, ray_dir: vec2<f32>, range: f32) -> vec4<f32> {
    // ...
    var color = vec4(0.0);
    var covered_range = 0.0;
    for (var r = 0u; r < MAX_RAYMARCH; r = r + 1u) {
        if ( // termination
            covered_range >= range ||
            any(position >= dimensions)
        ) {
            break;
        }

        var dist = textureLoad(tex_dist_field, coord, 0).r;
        if (dist < EPSILON) {
            color = textureLoad(tex_main, coord, 0);
            break;
        }
        position = position + ray_dir * dist;
        covered_range = covered_range + dist;
    }
    return color;
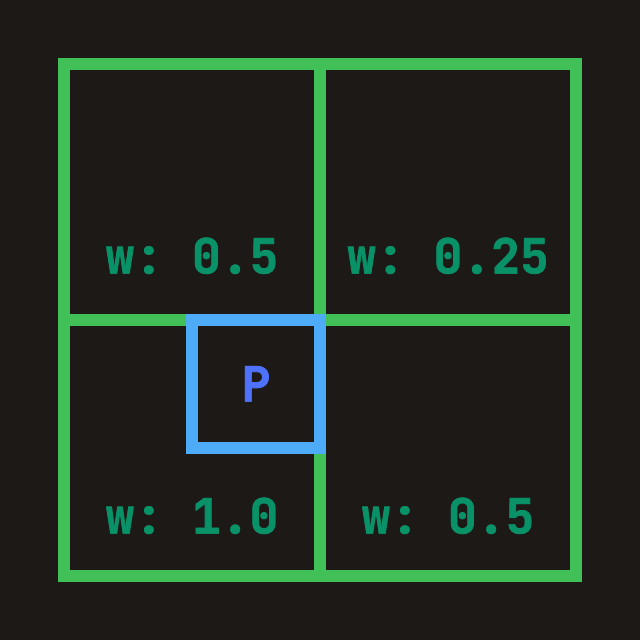
}«Fusionar desde la cascada interior (más fina) hacia la capa actual»: si la anchura actual de la sonda es W, la cascada anterior (ya escrita en tex_radiance_cascades_source) tiene prev_width = 2W, es decir, el doble de longitud de arista de la sonda y cuatro veces más muestras direccionales. Durante la fusión:
ray_index*4 … +3) sobre la dirección gruesa actual.fn merge(probe_cell: vec2<u32>, ray_index: u32) -> vec4<f32> {
let dimensions = textureDimensions(tex_radiance_cascades_source);
// Probe edge length in previous cascade texture.
// Current is W, previous is 2W, so previous has 4x rays.
let prev_width = probe.width * 2u;
let prev_ray_index_start = ray_index * 4u;
for (var p = 0u; p < 4u; p = p + 1u) {
let prev_ray_index = prev_ray_index_start + p;
let offset_coord = vec2<u32>(
prev_ray_index % prev_width,
prev_ray_index / prev_width,
);
// Sample all four spatial corners
TL = TL + fetch_cascade(
probe_cell_i,
probe_correction_offset + vec2<i32>(-1, -1),
offset_coord,
dimensions,
prev_width,
);
// TR / BL / BR omitted
}
let weight = vec2<f32>(0.75, 0.75)
- vec2<f32>(f32(probe_correction_offset.x), f32(probe_correction_offset.y)) * 0.5;
// Bilinear interpolation over accumulated corner radiance.
return mix(mix(TL, TR, weight.x), mix(BL, BR, weight.x), weight.y)
// Average the 4 fine rays into one coarse-direction result.
* 0.25;
}
Con WebGPU Inspector puedes inspeccionar el resultado fusionado final en rc_ping_b. Se ve con claridad que las zonas sin impacto se rellenan y producen una penumbra más suave.
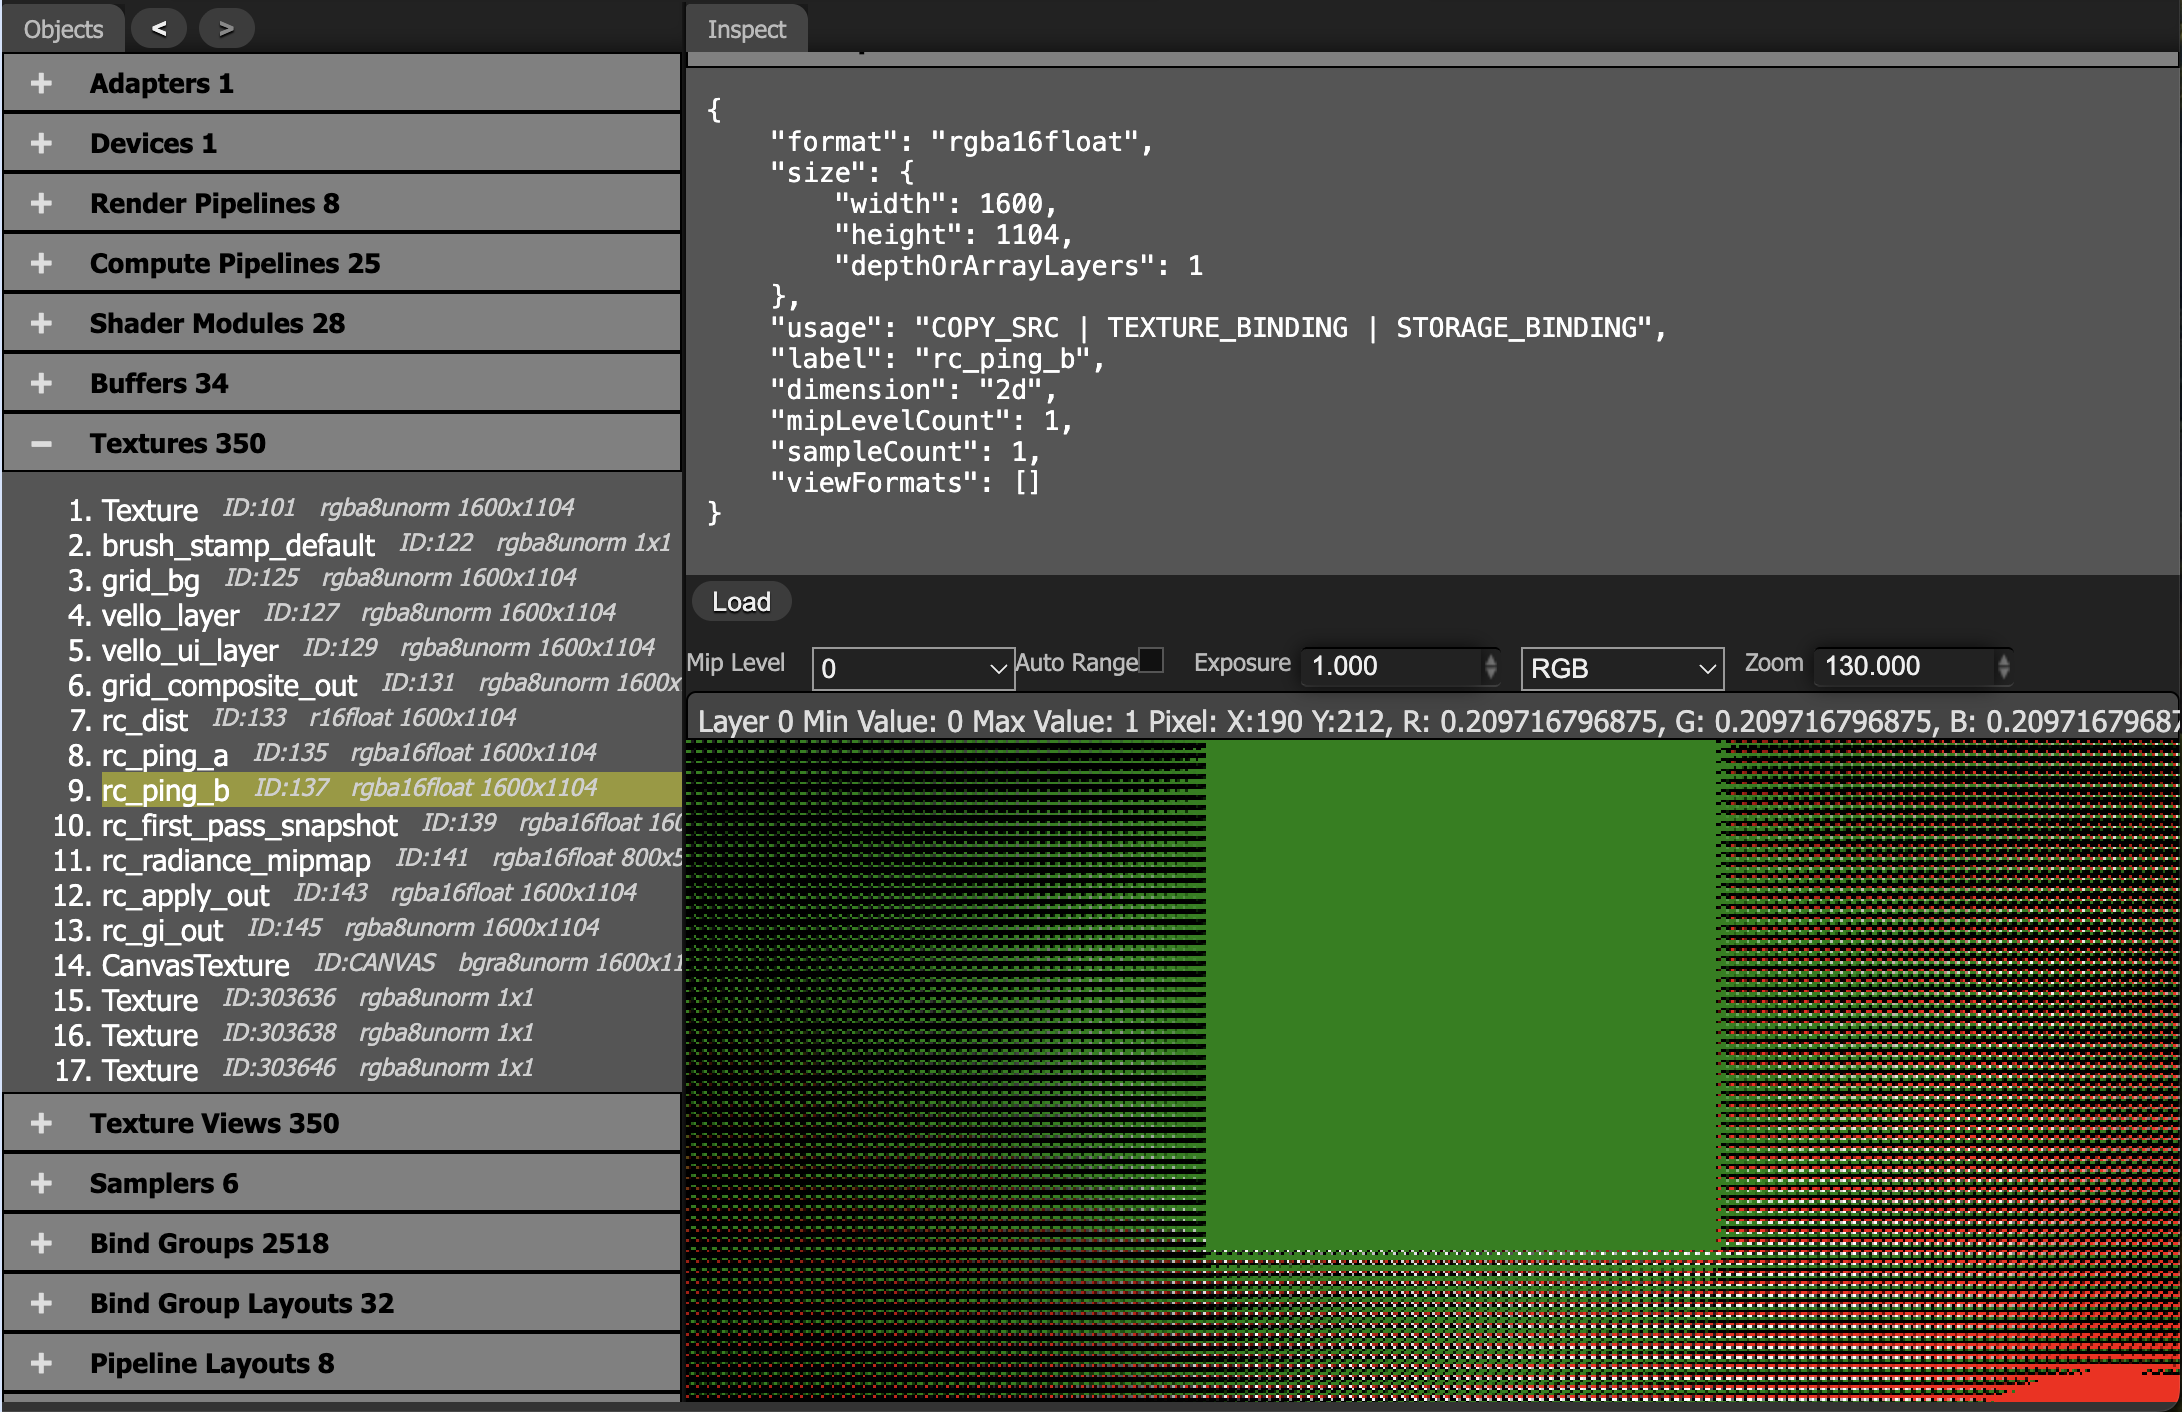
Cuando la separación entre sondas supera la escala del detalle de la sombra, la interpolación difumina los límites entre luz y sombra.
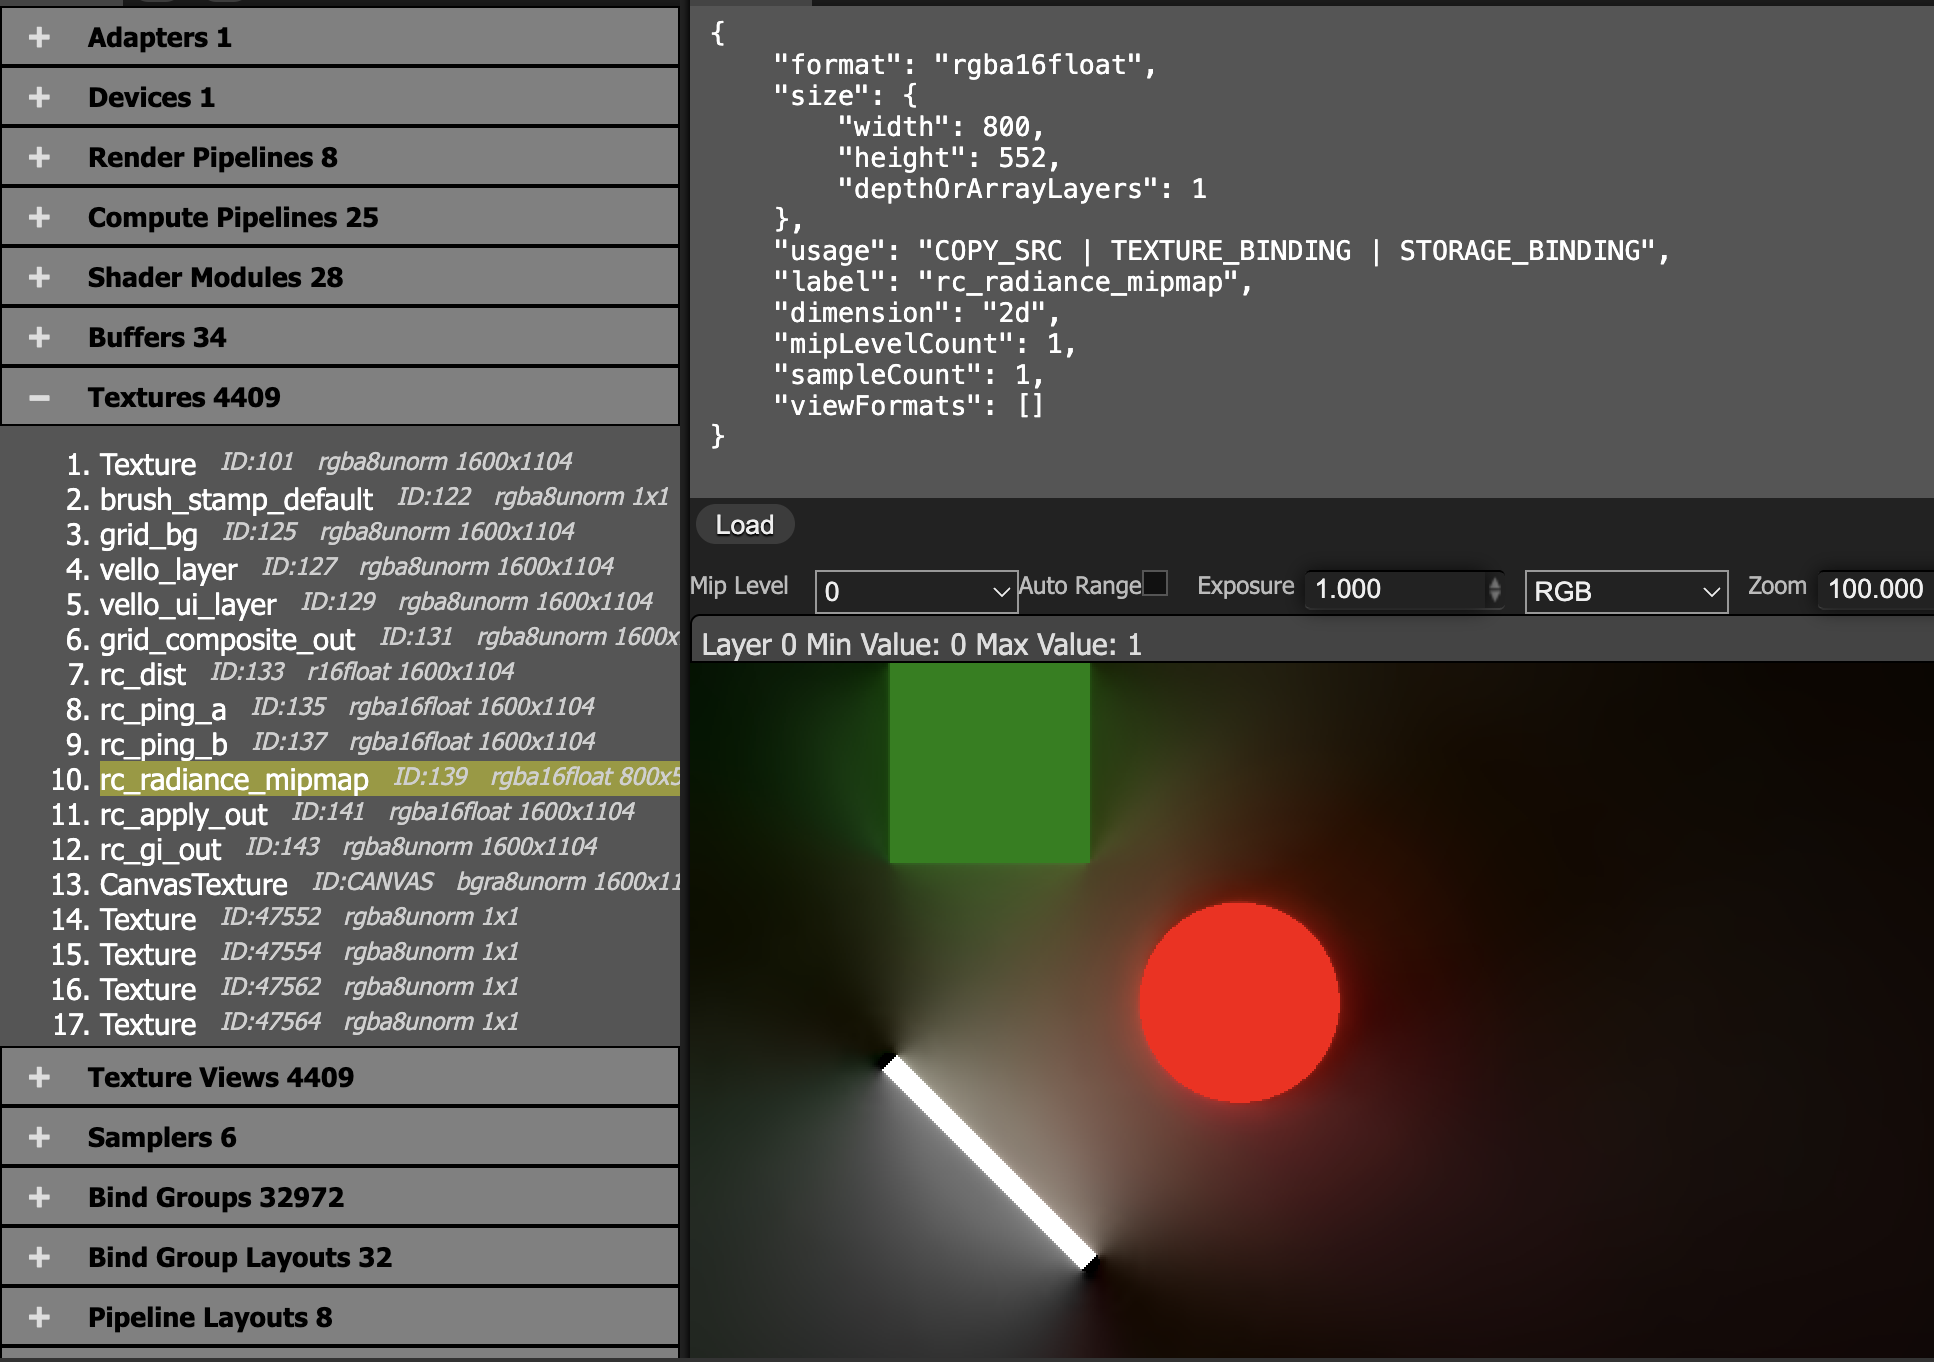
Promedia el resultado final de la cascada sobre la cuadrícula de sondas y escríbelo en un radiance_mipmap de menor resolución.
@group(0) @binding(0) var<uniform> probe: MipmapProbe;
@group(0) @binding(1) var tex_radiance_cascades: texture_2d<f32>;
@group(0) @binding(2) var tex_radiance_mipmap: texture_storage_2d<rgba16float, write>;

@compute @workgroup_size(8, 8, 1)
fn rc_radiance_mipmap(@builtin(global_invocation_id) global_id: vec3<u32>) {
  let base_coord = global_id.xy;
  let dimensions = textureDimensions(tex_radiance_mipmap);
  if any(base_coord >= dimensions) {
    return;
  }
  let pw = probe.width;
  let ray_count = pw * 2u;
  let probe_cell = base_coord * vec2<u32>(pw, pw);
  var accumulation = vec4(0.0);
  for (var y = 0u; y < pw; y = y + 1u) {
    for (var x = 0u; x < pw; x = x + 1u) {
      let coord = vec2<i32>(i32(probe_cell.x + x), i32(probe_cell.y + y));
      accumulation = accumulation + textureLoad(tex_radiance_cascades, coord, 0);
    }
  }
  accumulation = accumulation / f32(ray_count);
  textureStore(tex_radiance_mipmap, vec2<i32>(base_coord), accumulation);
}
main + radiance_mipmap: vuelve a sumar la iluminación indirecta al color principal.
@group(0) @binding(0) var tex_main: texture_2d<f32>;
@group(0) @binding(1) var sampler_main: sampler;
@group(0) @binding(2) var tex_radiance_mipmap: texture_2d<f32>;
@group(0) @binding(3) var sampler_radiance_mipmap: sampler;

@fragment
fn rc_apply_fs(i: VsOut) -> @location(0) vec4<f32> {
  let uv = vec2(i.ndc.x * 0.5 + 0.5, 0.5 - i.ndc.y * 0.5);
  let main = textureSample(tex_main, sampler_main, uv);
  let radiance = textureSample(tex_radiance_mipmap, sampler_radiance_mipmap, uv);
  return main + radiance;
}
Usa un sampler lineal para el mipmap:
let sampler_rc_mipmap = device.create_sampler(&SamplerDescriptor {
    label: Some("rc_mipmap_sampler"),
    mag_filter: FilterMode::Linear,
    min_filter: FilterMode::Linear,
    mipmap_filter: MipmapFilterMode::Nearest,
    ..Default::default()
});| RC clásico (2024 y anteriores) | RC holográfico (HRC) |
|---|---|
| Sondas discretas: promedios de rayos almacenados en puntos de la cuadrícula | Límites holográficos: iluminación direccional almacenada en los límites |
| Interpolación bilineal: suaviza los bordes duros de las sombras | Reconstrucción por integral de frontera: conserva las discontinuidades |
| Solo sombras suaves: adecuada para la luz indirecta y ambiental | Sombras duras y suaves: conserva los bordes nítidos de las sombras de luces puntuales |