Lección 23 - Mapa mental
Muchas aplicaciones de lienzo infinito admiten mapas mentales, como miro, excalidraw, canva, xmind, etc. Me gusta mucho el criterio de clasificación de excalidraw, que subdivide los mapas mentales en tres subtipos:
- El mapa de araña conviene para sesiones de lluvia de ideas: se extiende desde el tema central como una tela de araña. Desde el punto de vista del renderizado, mermaid también ofrece este tipo.
- Mapa de árbol
- Mapa de flujo
| Mapa de araña | Mapa de árbol | Mapa de flujo |
|---|---|---|
 |  |  |
Aquí solo trataremos el último tipo.
Aunque los mapas mentales pueden variar mucho en su presentación final, desde el punto de vista de la estructura de datos son árboles formados por nodos y aristas. markmap y mermaid convierten markdown en esta estructura. Los árboles son un tipo especial de grafo, y también hay algoritmos de disposición para grafos dirigidos, como dagre y elkjs, pero no los consideraremos aquí.
{
    "id": "Modeling Methods",
    "children": [
        {
            "id": "Classification",
            "children": []
        }
    ]
}
Para este tipo de datos, d3-hierarchy ofrece una serie de algoritmos listos para usar, y nos centramos solo en d3-tree.
d3-tree
Primero añadimos dos restricciones que más adelante veremos cómo romper: el objetivo es un árbol binario y todos los nodos tienen el mismo tamaño (o no tienen tamaño).
El enfoque de implementación de d3-tree procede de Dibujos más ordenados de árboles, que propone varios criterios estéticos a partir de investigaciones anteriores:
- Criterio estético 1: los nodos del mismo nivel del árbol deben situarse sobre una línea recta, y las rectas que definen los niveles deben ser paralelas.
- Criterio estético 2: un hijo izquierdo debe colocarse a la izquierda de su padre y un hijo derecho, a la derecha.
- Criterio estético 3: un padre debe quedar centrado sobre sus hijos.
- Criterio estético 4: un árbol y su imagen especular deben producir dibujos que sean reflejo el uno del otro; además, un subárbol debe dibujarse del mismo modo con independencia de dónde aparezca en el árbol.
El proceso de mejora de los tres primeros criterios se puede leer en Dibujar árboles presentables, que usa código Python y diagramas para mostrar en detalle el razonamiento algorítmico de los artículos anteriores. Por ejemplo, implementar el tercer criterio es sencillo: se usa un recorrido en postorden y se asigna a la coordenada x del nodo padre el punto medio entre el hijo más a la izquierda y el más a la derecha:
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L150
var midpoint = (children[0].z + children[children.length - 1].z) / 2;
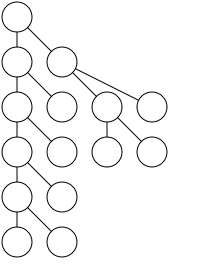
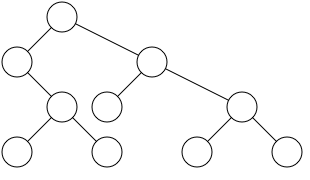
Se ve con claridad que todavía no es lo bastante simétrico y que el conjunto se desplaza hacia la derecha, lo que lleva al cuarto criterio:
| Tan estrecho como sea posible | Un padre debe quedar centrado sobre sus hijos |
|---|---|
 |  |
La operación de centrar el nodo padre puede entrar en conflicto con la posición de sus hermanos. En ese momento hay que mover todo el subárbol, pero, si se usa el enfoque recursivo siguiente, la complejidad del algoritmo pasa a ser
def move_right(branch, n):
    branch.x += n
    for c in branch.children:
        move_right(c, n)
Entonces hay que añadir a los nodos un atributo mod, de modo que la operación de centrar el padre pueda ignorar temporalmente los conflictos y mover después. Así se evita la recursión y la complejidad del algoritmo vuelve a prelim, cuyo nombre procede de Un algoritmo de posicionamiento de nodos para árboles generales:
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L67
function TreeNode(node, i) {
    this._ = node; // final position: _.x
    this.parent = null;
    this.children = null;
    this.z = 0; // prelim
    this.m = 0; // mod
}
Como se usa un recorrido en postorden:
function tree(root) {
    var t = treeRoot(root);
    t.eachAfter(firstWalk);
    t.eachBefore(secondWalk);
}
En el segundo recorrido, en preorden, se acumula mod de forma recursiva para completar el desplazamiento hacia la derecha y obtener la posición final _.x. Esto corresponde al paso PETRIFY del artículo original:
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L164
function secondWalk(v) {
    v._.x = v.z + v.parent.m; // final x
    v.m += v.parent.m;
}
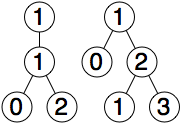
Aquí hay que introducir el concepto de contour. Por ejemplo, el contorno derecho del árbol de la izquierda de abajo es [1, 1, 2] y el contorno izquierdo del árbol de la derecha es [1, 0, 1]. Cuando hay que impedir que estos dos subárboles se solapen, basta con comparar esos dos contornos para determinar cuánta distancia debe moverse el árbol derecho hacia la derecha. En este ejemplo, la distancia de movimiento es 2.
def push_right(left, right):
    wl = contour(left, lt)
    wr = contour(right, gt)
    return max(x-y for x,y in zip(wl, wr)) + 1
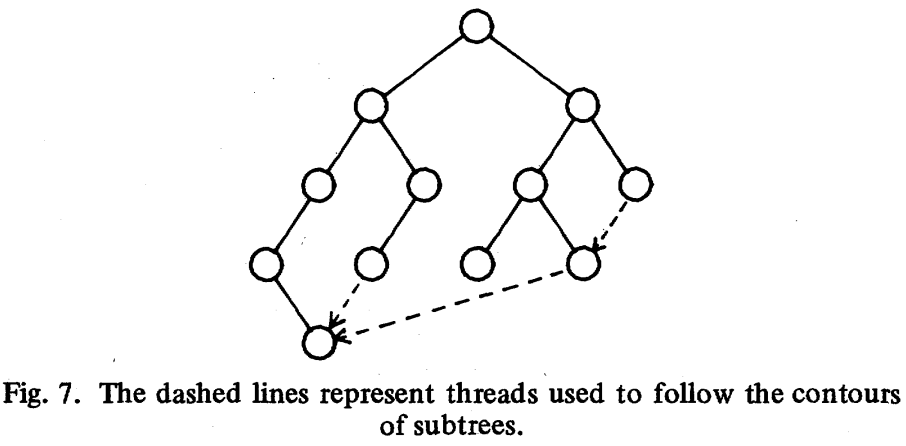
El algoritmo para obtener los contornos de los subárboles sigue necesitando recursión, así que la complejidad es thread. En la figura de abajo, las líneas discontinuas representan esta relación, distinta de la de padre e hijo, y perfilan los contornos de cada subárbol, que quizá no existan de verdad:
function TreeNode(node, i) {
    this.t = null; // thread
}
De este modo, al calcular contour se puede atravesar la jerarquía real y obtenerlo directamente mediante thread, lo que reduce la complejidad a
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L15C1-L24C2
function nextLeft(v) {
    var children = v.children;
    return children ? children[0] : v.t;
}
function nextRight(v) {
    var children = v.children;
    return children ? children[children.length - 1] : v.t;
}
Análisis de complejidad
Repasemos el algoritmo. Primero se hace un recorrido en postorden para calcular las coordenadas relativas y el thread de los nodos; después, un recorrido en preorden para acumular mod y determinar la posición absoluta de cada nodo. Está claro que cada nodo se visita solo una vez en estos dos recorridos. Por tanto, solo hay que determinar la complejidad del barrido de contornos en el primer recorrido.
El artículo original también ofrece un análisis matemático de la complejidad de este paso.
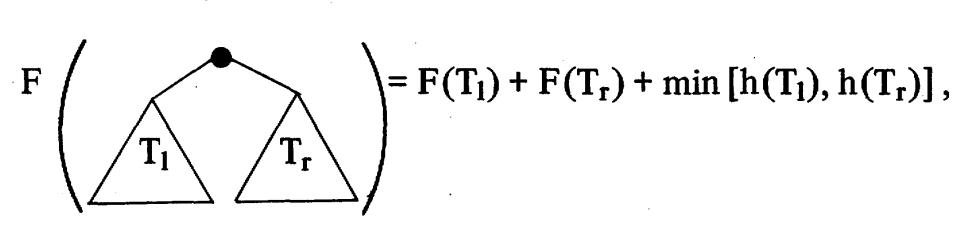
A continuación solo hay que demostrar
El autor propone la hipótesis
Por inducción, se cumple para
Según la definición (añadiendo el nodo raíz):
Sustituyendo:
Por tanto:
Extensión a árboles N-arios
Se pueden procesar los subárboles que se desplazan de izquierda a derecha en secuencia, pero eso produce la figura (a) de abajo. También se podría añadir un recorrido de derecha a izquierda, pero eso produciría la situación (b). Lo que se quiere es el efecto de (d):
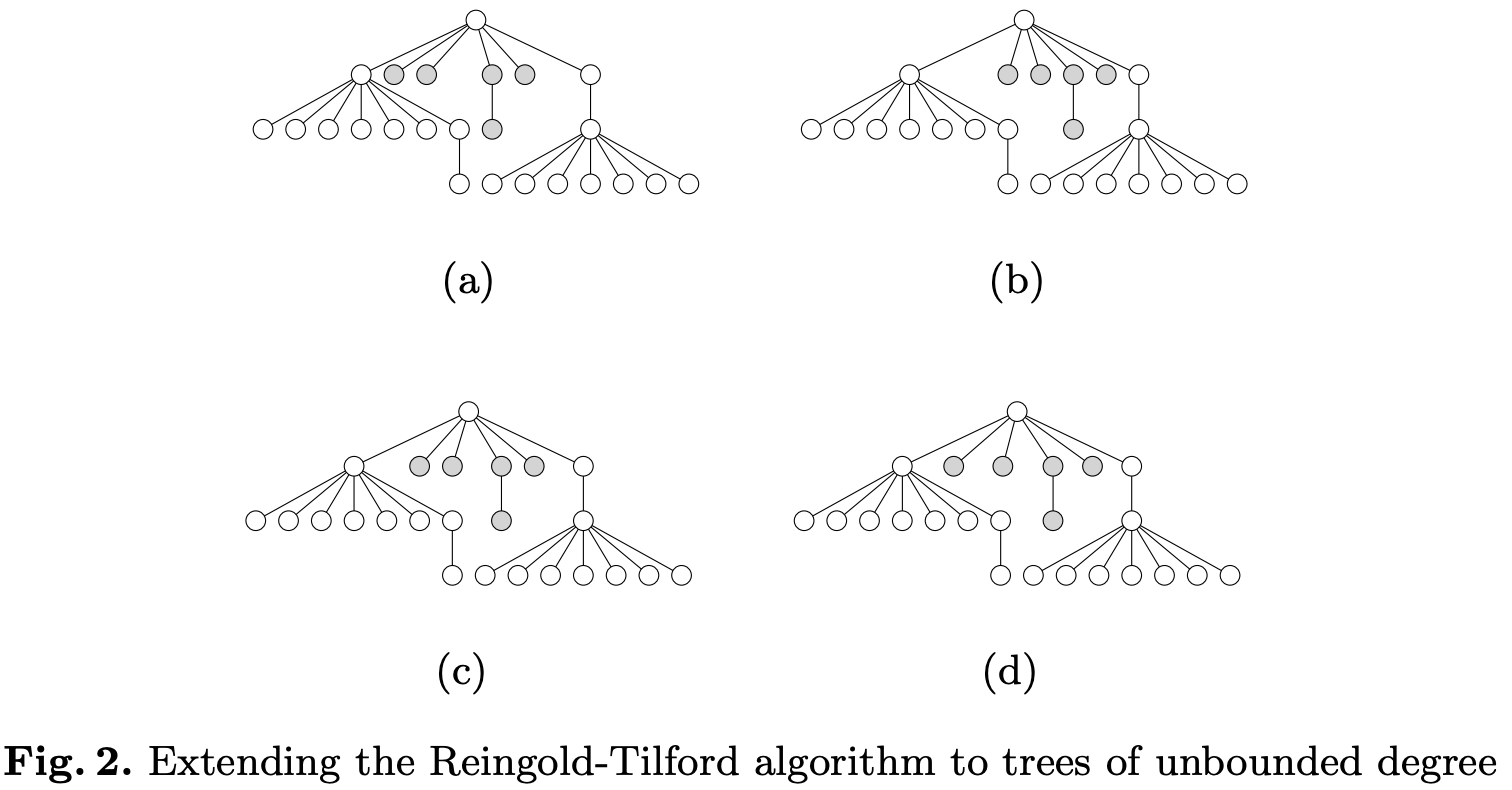
Un algoritmo de posicionamiento de nodos para árboles generales propuso una solución. Conviene señalar que la estructura del código y los nombres de variables de d3-tree reutilizan en lo esencial este artículo. La figura de abajo muestra el efecto de redisposición durante el proceso de añadir subárboles:
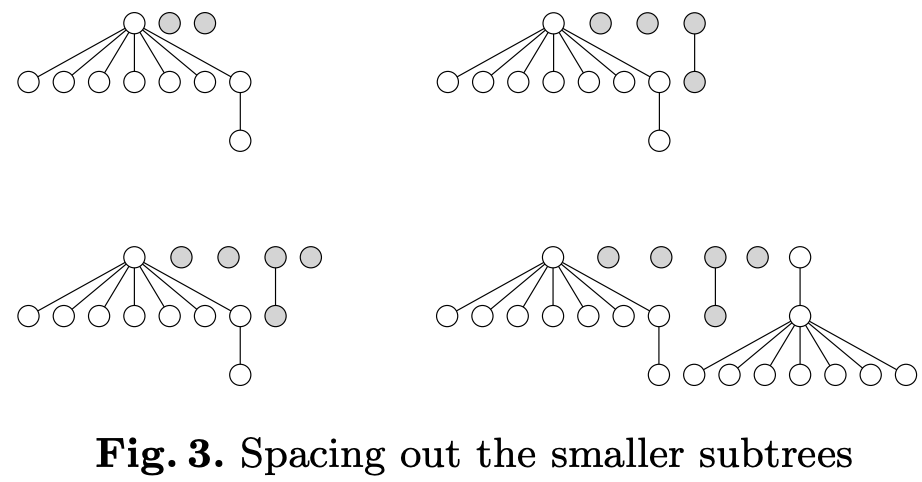
La función apportion es la lógica central de «alineación entre subárboles» de toda la disposición. Se encarga de comparar los contornos del subárbol actual con el subárbol anterior; si se solapan, añade un shift al subárbol actual; actualiza el modificador para que los nodos descendientes también se ajusten; y suaviza los modificadores intermedios para evitar «huecos».
function apportion(v):
    leftMost = firstChild(v)
    rightMost = lastChild(v)
    defaultAncestor = leftMost

    for each child w from second to last:
        leftSibling = previousSibling(w)

        # Initialize contour pointers
        vip = w
        vim = leftSibling
        sip = vip.mod
        sim = vim.mod

        # Compare right contour of vim and left contour of vip
        while vim ≠ null and vip ≠ null:
            shift = (vim.prelim + sim + separation) - (vip.prelim + sip)

            if shift > 0:
                # Move current subtree right
                moveSubtree(ancestor(w, v, defaultAncestor), v, shift)
                sip += shift

            # move to next lower level
            vim = rightmostChild(vim)
            vip = leftmostChild(vip)

            sim += vim?.mod or 0
            sip += vip?.mod or 0

        # update default ancestor
        if rightMostChild(vim) ≠ null and leftMostChild(vip) == null:
            defaultAncestor = ancestor(w, v, defaultAncestor)
Sigue añadiendo atributos a los nodos para guardar shift:
function TreeNode(node, i) {
    this.c = 0; // change
    this.s = 0; // shift
    this.A = null; // default ancestor
    this.a = this; // ancestor
}
Donde moveSubtree mueve todo el subárbol con raíz en wp hacia la derecha shift unidades.
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L28C10-L28C21
function moveSubtree(wm, wp, shift) {
    var change = shift / (wp.i - wm.i);
    wp.c -= change;
    wp.s += shift;
    wm.c += change;
    wp.z += shift;
    wp.m += shift;
}
Esta implementación tiene una complejidad de
Si necesitas mostrarlo en horizontal, basta con transponer el sistema de coordenadas intercambiando las coordenadas x/y de los nodos.
d3-flextree
El algoritmo anterior tiene una limitación evidente: exige que todos los nodos tengan la misma anchura y la misma altura, igual que muchos ejemplos de d3-tree usan círculos del mismo tamaño como nodos. Recomiendo mucho leer Dibujar árboles ordenados no estratificados en tiempo lineal y Visualización de árboles ordenados de alto rendimiento.
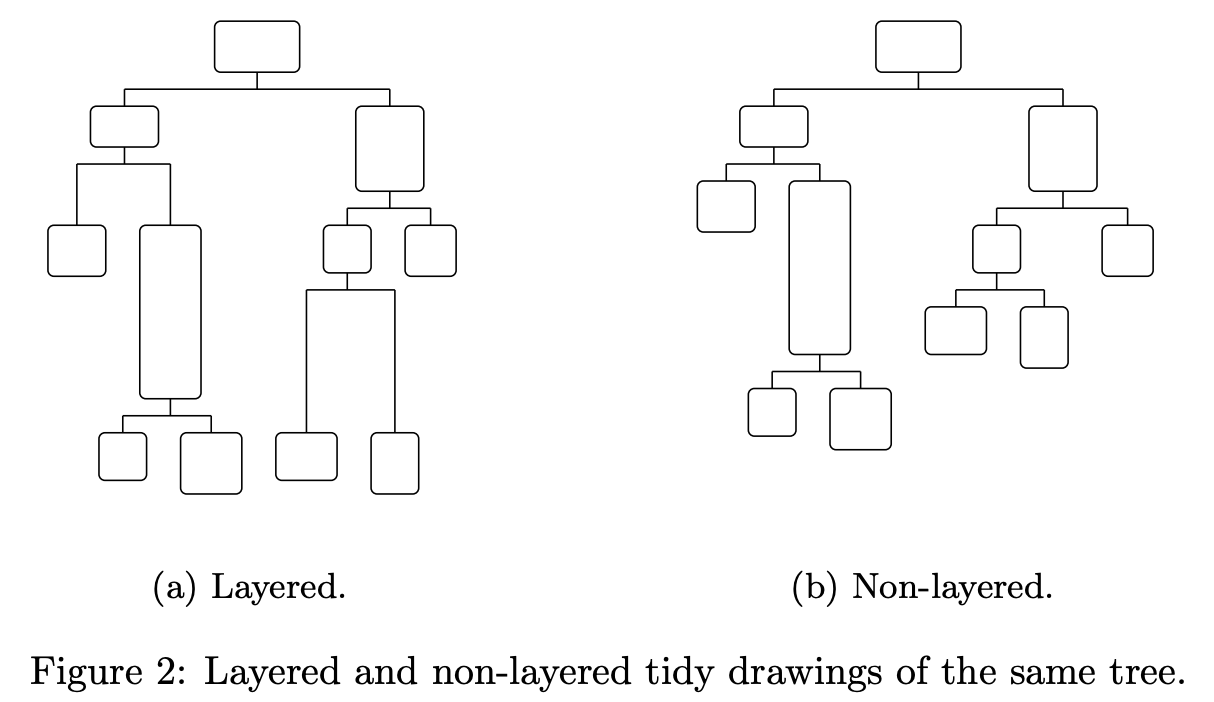
d3-flextree se creó para resolver este problema, y markmap lo usa.
Una limitación de ese algoritmo es que se aplica a árboles en los que todos los nodos tienen el mismo tamaño. Esto basta para muchas aplicaciones, pero a menudo es preferible una solución más general, que permita tamaños de nodo variables.
El efecto es el siguiente:
@antv/hierarchy
El algoritmo mindmap de @antv/hierarchy y mindmap-layouts propone estos requisitos estéticos:
- Nodo raíz centrado
- Los nodos hijo se pueden distribuir a izquierda y derecha (normalmente de forma simétrica, o según
getSide) - Los nodos del mismo nivel se disponen de manera uniforme en vertical
También admite definir el tamaño de los nodos y no usa el enfoque de barrido de contornos. Los pasos generales son los siguientes, con una complejidad global del algoritmo de
- Primer pase: fija con rapidez una coordenada x básica.
- Segundo pase: calcula, de abajo arriba, el espacio vertical que necesita cada subárbol.
- Tercer pase (fase de ajuste): de arriba abajo, usa la información de espacio calculada para asignar coordenadas y que no se solapen a todos los nodos hijo.
- Cuarto pase: de nuevo de abajo arriba, a partir de la disposición final de los nodos hijo, afina las posiciones de los nodos padre para lograr el centrado vertical.
El efecto es el siguiente:
[WIP] Interacción
Los mapas mentales tienen muchas interacciones especiales, entre ellas hacer clic en los nodos para expandir o contraer los nodos hijo.